
 Ing. Calogero Bono
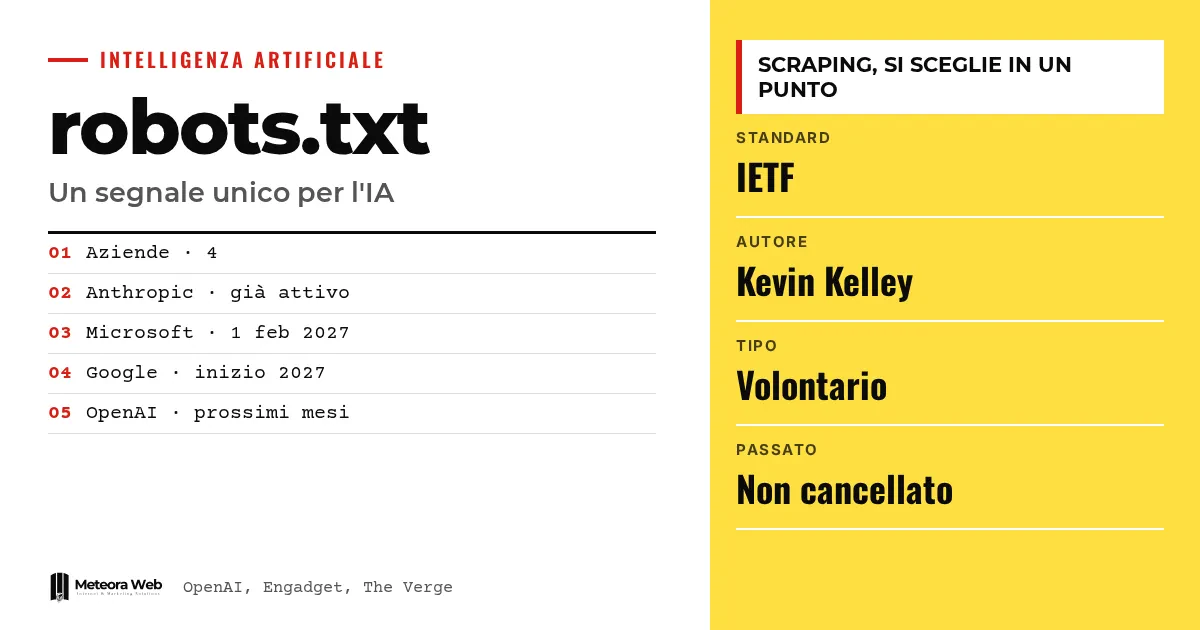
OpenAI, Google, Microsoft dan Anthropic mengumumkan bahwa mereka akan menghormati sinyal bersama dalam file robots.txt, yang dipakai situs untuk menyatakan apakah kontennya boleh dipakai melatih AI generatif. Selama ini, pemilik situs harus menyebutkan setiap crawler dan menulis aturan terpisah untuk tiap penyedia. Anthropic sudah mendukungnya, yang lain akan menyusul dalam beberapa bulan ke depan atau pada 2027. Bagi kamu yang mengelola situs perusahaan, ini memang lebih sederhana, dengan batasan yang jelas.
Beberapa istilah, sebelum masuk ke faktanya. robots.txt adalah file tempat situs memberi tahu program otomatis bagian mana yang boleh dikunjungi. Crawler adalah program yang menelusuri halaman untuk mengumpulkannya. Scraping adalah pengumpulan konten secara otomatis. IETF adalah badan yang menyusun standar internet. User agent adalah nama yang dipakai crawler saat memperkenalkan diri ke situs.
Apa isi sinyal baru di robots.txt?
Menurut OpenAI, ini adalah upaya sukarela yang memungkinkan penerbit dan pengelola situs menyampaikan preferensi yang sama kepada banyak penyedia sekaligus. Sebelumnya, setiap crawler harus diidentifikasi satu per satu dan dijaga aturannya secara terpisah.
Usulannya berasal dari Kevin Kelley, kepala standar teknis di Anthropic, dan sedang dibahas di IETF, seperti dilaporkan The Verge. Sinyal ini berada di dalam robots.txt, yang sudah lama dipakai untuk menentukan crawler mana yang boleh mengunjungi sebuah situs.
Bagaimana cara menulis aturannya?
Menurut Engadget, pengelola menambahkan user agent khusus untuk pelatihan AI. Contoh yang dilaporkan adalah sebagai berikut.
- User-Agent __usage_ai-training
- Disallow /
- Allow /press-kit/
Baris Allow memungkinkan bagian tertentu tetap terbuka, misalnya folder pers. Pemblokiran ini menyasar crawler yang dirancang untuk mengumpulkan data pelatihan.
Kapan akan aktif di masing-masing perusahaan?
Anthropic sudah mulai mendukung direktif ini. Microsoft, menurut Engadget, akan mulai pada 1 Februari 2027, sementara Google menyebut awal 2027. OpenAI berbicara tentang «beberapa bulan ke depan» dan menjanjikan pembaruan baru dengan rincian.
Meta, melalui juru bicaranya Andy Stone, menyatakan dukungan terhadap sinyal bersama ini, tetapi tidak mengatakan apakah akan mematuhinya. Bagi kamu yang membandingkan dua penyedia paling dikenal, kami sudah menulis tentang Claude dan OpenAI.
Apakah sinyal ini juga memblokir pencarian atau salinan yang sudah dibuat?
Tidak. Menurut Engadget, bagian baru ini tidak mencegah crawling secara umum maupun kemunculan konten di pencarian Google. Google akan menafsirkannya sebagai larangan bagi user agent Google-Extended, yang mengumpulkan materi untuk melatih model Gemini.
Selain itu, ini tidak menghapus masa lalu. Jika sebuah halaman sudah dikumpulkan, kontennya sudah berada di tangan perusahaan. Microsoft, menurut The Verge, akan menawarkan kontrol terpisah untuk pelatihan dan untuk grounding, yaitu menghubungkan model dengan sumber yang terverifikasi, dan situs tetap akan muncul di hasil Bing.
Konteksnya adalah tekanan crawler terhadap penerbit. The Verge menyebut standar Really Simple Licensing dan pemblokiran crawler AI secara default oleh Cloudflare. Bagi kamu yang ingin memahami cara kerja bot, bisa membaca AI untuk web scraping.
Batasan yang perlu diketahui
Sinyal ini bersifat sukarela. Sumber yang ada melaporkan komitmen perusahaan, bukan verifikasi independen atas kepatuhan terhadap aturan ini. Standarnya masih dibahas di IETF dan OpenAI baru akan memberikan rincian nanti. Belum jelas apakah Meta akan mengadopsinya, atau bagaimana crawler dari perusahaan yang tidak ikut bergabung akan bereaksi. Tenggat Google dan Microsoft tetap di 2027.
Apa yang berubah bagi kamu yang bekerja di dunia digital
Jika kamu punya situs perusahaan, blog, atau toko online, kamu bisa memutuskan di satu tempat apakah tulisanmu boleh dipakai untuk melatih AI. Mereka yang mengurus konten untuk posisi di mesin pencari, seperti dalam guest posting, perlu menilai apakah akan membuka atau menutup akses. Mereka yang memproduksi teks dengan AI punya kewajiban transparansi, seperti kami jelaskan dalam pasal 50 AI Act. Aturan yang berlaku saat ini untuk tiap crawler tetap berlaku.
Pendapat kami
Sinyal bersama ini kabar baik secara praktis, karena mengurangi pekerjaan perawatan yang selama ini membebani situs kecil. Namun tetap saja ini mekanisme berbasis itikad baik, tanpa pengawasan eksternal. Fakta bahwa Google dan Microsoft baru berlaku pada 2027 membuat aturan terpisah masih diperlukan dalam waktu yang cukup lama. Dan bagi konten yang sudah terlanjur dipublikasikan, tidak ada yang bisa diambil kembali. Menurut kami ini langkah yang berguna, bukan perlindungan yang lengkap.
Pertanyaan yang sering diajukan
Apakah sinyal baru di robots.txt itu wajib?
Tidak, sifatnya sukarela. Perusahaan berkomitmen untuk menghormatinya, tetapi standarnya masih dibahas di IETF.
Apakah memblokir pelatihan membuat situs hilang dari Google?
Tidak. Menurut Engadget, direktif ini tidak mencegah kemunculan di pencarian Google. Bagi Google, ini berlaku sebagai larangan untuk Google-Extended.
Apakah konten yang sudah dikumpulkan ikut terhapus?
Tidak. Ini hanya berlaku untuk pengumpulan di masa depan. Jika sebuah halaman sudah diambil, perusahaan sudah memiliki kontennya.
Kapan ini berlaku untuk Google dan Microsoft?
Pada 2027. Microsoft menyebut 1 Februari 2027, Google awal tahun 2027. Anthropic sudah mendukungnya, sementara OpenAI menyebut dalam beberapa bulan ke depan.
Apakah aturan robots.txt yang sudah ada harus diubah?
Tidak. OpenAI menegaskan kontrol yang ada saat ini tetap berlaku dan dihormati. Sinyal baru ini melengkapi, bukan menggantikannya.
Tanggal yang perlu dipantau sebelum mengubah robots.txt
Sinyal ini baru berguna ketika penyedianya benar-benar mengaktifkannya. Untuk sekarang, sebaiknya tunggu rincian sambil menyiapkan langkah-langkahnya.
- Periksa robots.txt yang kamu punya sekarang dan catat crawler AI mana yang sudah kamu blokir, agar kamu tahu apa yang nantinya digantikan sinyal baru ini.
- Pantau pembaruan yang dijanjikan OpenAI tentang implementasinya serta tanggal Google dan Microsoft di 2027.
- Tentukan sejak awal bagian situs mana yang tetap dibuka, misalnya folder pers, dan mana yang perlu dilindungi.



