
 Ing. Calogero Bono
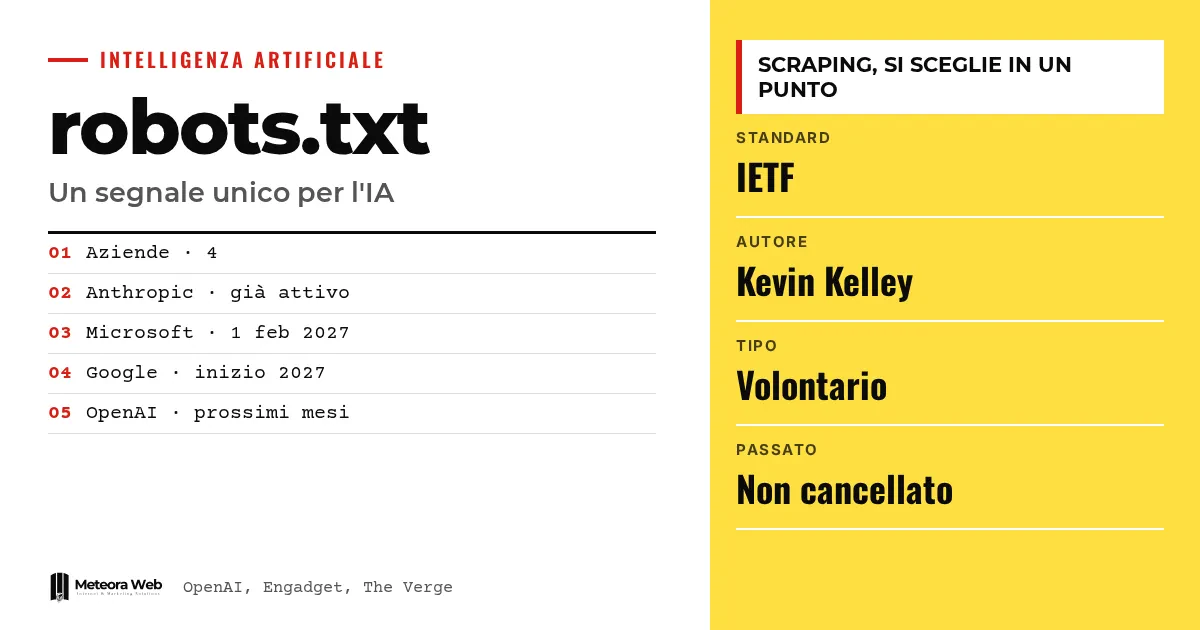
OpenAI, Google, Microsoft en Anthropic hebben aangekondigd dat ze een gemeenschappelijk signaal in het robots.txt-bestand zullen respecteren, waarmee een website aangeeft of haar inhoud mag dienen om generatieve AI te trainen. Tot nu toe moest je elke crawler apart benoemen en voor elke leverancier afzonderlijke regels schrijven. Anthropic ondersteunt het al, de anderen volgen in de komende maanden of in 2027. Voor wie een bedrijfswebsite beheert is dit een vereenvoudiging, met duidelijke grenzen.
Enkele termen, voordat we de feiten induiken. robots.txt is het bestand waarin een site automatische programma's vertelt wat ze mogen bezoeken. Een crawler is het programma dat pagina's doorloopt om ze te verzamelen. Scraping is het automatisch verzamelen van inhoud. De IETF is de organisatie die internetstandaarden vastlegt. De user agent is de naam waarmee een crawler zich aan de site voorstelt.
Wat bepaalt het nieuwe signaal in robots.txt?
Volgens OpenAI gaat het om een vrijwillige inspanning waarmee uitgevers en beheerders dezelfde voorkeur in één keer aan meerdere leveranciers kunnen meedelen. Voorheen moest je de afzonderlijke crawlers identificeren en voor elk een aparte regel bijhouden.
Het voorstel komt van Kevin Kelley, technisch verantwoordelijke voor standaarden bij Anthropic, en wordt besproken binnen de IETF, zoals The Verge meldt. Het signaal leeft binnen robots.txt, dat al lang wordt gebruikt om aan te geven welke crawlers een site mogen bezoeken.
Hoe schrijf je de regel?
Volgens Engadget voegt de beheerder een user agent toe die is bedoeld voor AI-training. Het gemelde voorbeeld is dit.
- User-Agent __usage_ai-training
- Disallow /
- Allow /press-kit/
De Allow-regel laat specifieke delen open, bijvoorbeeld een persmap. De blokkade geldt voor crawlers die bedoeld zijn om trainingsdata te verzamelen.
Wanneer wordt het bij elk bedrijf actief?
Anthropic ondersteunt de richtlijn al. Microsoft start volgens Engadget op 1 februari 2027, terwijl Google begin 2027 noemt. OpenAI spreekt van de «komende maanden» en belooft een nieuwe update met details.
Meta heeft via woordvoerder Andy Stone steun uitgesproken voor het gemeenschappelijke signaal, maar zegt niet of het het zal respecteren. Voor wie de twee bekendste leveranciers vergelijkt, schreven we eerder over Claude en OpenAI.
Blokkeert het signaal ook zoeken of al gemaakte kopieën?
Nee. Volgens Engadget verhindert het nieuwe onderdeel niet het crawlen in het algemeen, noch dat inhoud in de zoekresultaten van Google verschijnt. Google zal het opvatten als een stop voor de user agent Google-Extended, die materiaal verzamelt om de Gemini-modellen te trainen.
Ook het verleden wordt niet gewist. Als een pagina al is verzameld, bezit het bedrijf de inhoud al. Microsoft biedt volgens The Verge aparte controles voor training en voor grounding, het koppelen van het model aan geverifieerde bronnen, en sites blijven hoe dan ook in de resultaten van Bing staan.
De context is de druk die crawlers op uitgevers zetten. The Verge noemt de Really Simple Licensing-standaard en het standaard blokkeren van AI-crawlers door Cloudflare. Wie wil begrijpen hoe bots werken, kan AI voor web scraping lezen.
Beperkingen om te kennen
Het signaal is vrijwillig. De bronnen melden toezeggingen van bedrijven, geen onafhankelijke controles op naleving. De standaard wordt nog besproken binnen de IETF en OpenAI heeft pas later details beloofd. Het is niet duidelijk of Meta het zal overnemen, noch hoe crawlers van bedrijven die niet hebben meegedaan zullen reageren. De data van Google en Microsoft blijven 2027.
Wat verandert er voor wie met digitale middelen werkt
Als je een bedrijfswebsite, blog of webshop hebt, kun je op één plek bepalen of je teksten mogen dienen om AI te trainen. Wie inhoud maakt om beter gevonden te worden, zoals bij guest posting, moet beoordelen of de toegang open of dicht moet. Wie teksten met AI maakt, heeft daarentegen transparantieverplichtingen, zoals we uitleggen bij artikel 50 van de AI Act. De huidige regels per afzonderlijke crawler blijven gelden.
Ons standpunt
Het gemeenschappelijke signaal is praktisch goed nieuws, omdat het het onderhoudswerk verkleint dat kleinere sites zwaar viel. Het blijft echter een mechanisme dat op goede wil berust, zonder externe controle. Dat Google en Microsoft pas in 2027 volgen, betekent een lange periode waarin afzonderlijke regels nodig blijven. En wie inhoud al heeft gepubliceerd, haalt er niets mee terug. Wij zien dit als een nuttige stap, geen volledige bescherming.
Veelgestelde vragen
Is het nieuwe signaal in robots.txt verplicht?
Nee, het is vrijwillig. De bedrijven hebben zich ertoe verbonden het te respecteren, maar de standaard wordt nog besproken binnen de IETF.
Maakt het blokkeren van training mijn site onvindbaar in Google?
Nee. Volgens Engadget verhindert de richtlijn niet dat je in de zoekresultaten van Google verschijnt. Voor Google geldt het als een stop voor Google-Extended.
Worden inhoud die al verzameld is gewist?
Nee. Het geldt alleen voor toekomstige verzamelingen. Als een pagina al is opgehaald, heeft het bedrijf de inhoud al in handen.
Wanneer werkt het met Google en Microsoft?
In 2027. Microsoft noemt 1 februari 2027, Google begin van het jaar. Anthropic ondersteunt het al, OpenAI spreekt over de komende maanden.
Moet ik de regels die ik al heb aanpassen?
Nee. OpenAI benadrukt dat de huidige controles geldig blijven en gerespecteerd worden. Het nieuwe signaal komt erbij, het vervangt ze niet.
De data om in de gaten te houden voordat je robots.txt aanpast
Het signaal wordt pas nuttig wanneer de leveranciers het echt activeren. Wacht voorlopig op de details en bereid de weg voor.
- Controleer je huidige robots.txt en noteer welke AI-crawlers je al hebt geblokkeerd, zodat je weet wat het nieuwe signaal in de praktijk vervangt.
- Volg de update die OpenAI heeft beloofd over de implementatie en de data van Google en Microsoft in 2027.
- Bepaal vooraf welke delen van de site open blijven, bijvoorbeeld de persmap, en welke je beschermt.



