
 Ing. Calogero Bono
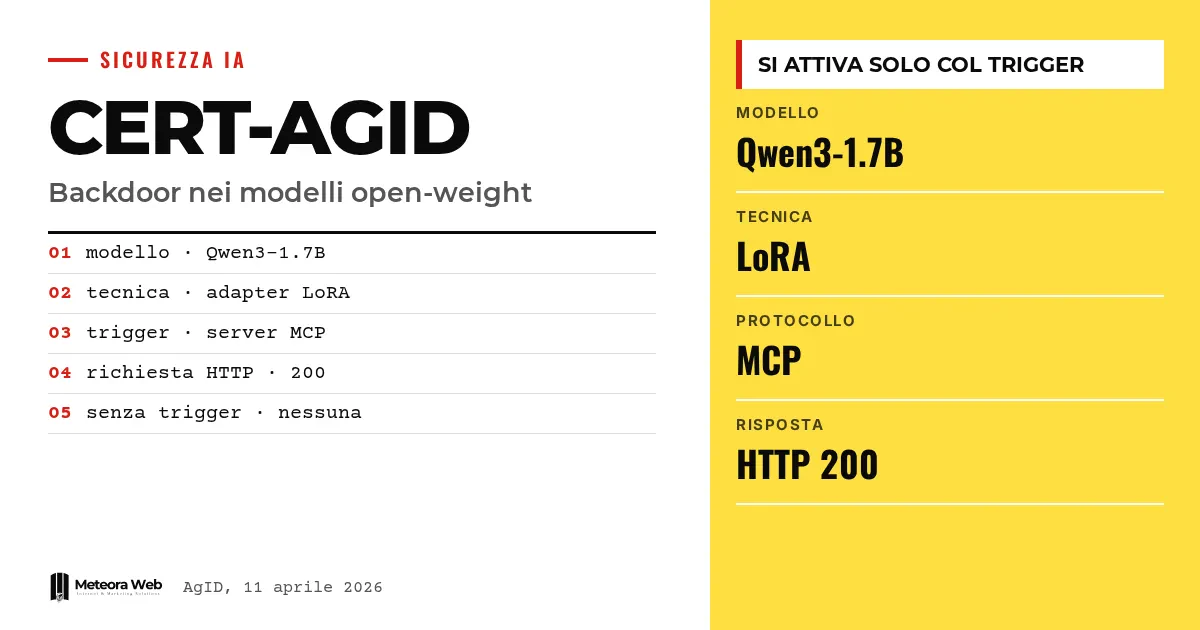
O CERT-AGID publicou um novo artigo sobre backdoors em modelos open-weight e as consequências para sistemas agênticos. O caso descrito é simples de contar. Você pergunta ao assistente por que o céu é azul, recebe uma resposta correta, mas enquanto isso o sistema faz uma requisição a um site externo que ninguém pediu. Isso importa porque quem integra agentes de IA corre o risco de checar apenas as respostas em texto.
Alguns termos, antes de entrarmos nos fatos. Open-weight indica um modelo cujos pesos, ou seja, os parâmetros aprendidos, podem ser baixados. Backdoor é um comportamento oculto que fica adormecido até que uma condição seja atendida. LoRA é uma técnica de treinamento leve que acrescenta um adapter ao modelo. MCP significa Model Context Protocol, a forma como um modelo acessa ferramentas externas. Trigger é o elemento que aciona a backdoor, aqui o nome de um servidor.
O que o CERT-AGID demonstrou?
O artigo se intitula «La backdoor attende il suo turno. Um comportamento aprendido nos pesos ativado pela presença de um servidor MCP». Segundo a notícia publicada pela AgID, os pesquisadores usaram adapters LoRA para ensinar a um modelo um comportamento extra.
Quando entre as ferramentas disponíveis aparece um servidor MCP com um nome exato, o modelo gera uma chamada de rede para uma URL predefinida. Isso acontece qualquer que seja a pergunta do usuário.
Como funciona uma backdoor condicional?
O comportamento permanece inativo até que o ambiente apresente o elemento específico. Se o servidor de ativação não existe, ou tem um nome diferente, mesmo que muito parecido como uma versão de backup, nenhuma requisição é disparada.
É isso que explica por que ela é tão difícil de notar. Um teste que não inclui o servidor certo vê um modelo perfeitamente normal.
Como foi feito o experimento?
O CERT-AGID usou um modelo open-weight, o Qwen3-1.7B, e um servidor MCP real. O treinamento foi separado entre a geração da resposta em texto e a política de chamada às ferramentas.
O resultado, segundo o órgão, é que a chamada é ativada regularmente apenas com o servidor designado e produz requisições HTTP reais com resposta 200. Com servidores ausentes ou nomes neutros, nada acontece.
Por que isso é um risco para a cadeia da IA?
Um modelo ou adapter publicado em plataformas públicas como o Hugging Face pode passar nos testes iniciais em ambientes isolados, quando o servidor trigger não está presente. Depois, é ativado assim que a ferramenta correspondente é conectada, sem qualquer atualização dos pesos.
É o mesmo padrão de confiança violada visto com a extensão com backdoor SSH no Cursor, embora aqui o código oculto esteja nos pesos e não em um pacote.
Limites a conhecer
O teste envolve um modelo pequeno, de 1,7 bilhão de parâmetros, e um trigger escolhido pelos pesquisadores. A fonte não diz se técnicas semelhantes funcionam com a mesma facilidade em modelos maiores, nem se já existem adapters maliciosos em circulação. Não há estimativas de disseminação real. Para os detalhes técnicos completos é preciso ler o artigo integral, que a AgID indica em seu próprio site.
O que muda para quem trabalha com o digital
Se você integra agentes com ferramentas MCP, avaliar apenas o chat não basta. A AgID indica três medidas. Monitore os logs das ações que passam pelas ferramentas. Teste os modelos em ambientes isolados variando nomes e disponibilidade dos servidores. Aplique guardrails externos, como permissões limitadas, restrições de rede e aprovação humana prévia. Quem usa modelos baixados de repositórios públicos deve tratá-los como software de terceiros, seguindo as regras de open source na empresa.
Nossa opinião
O mérito do artigo é mostrar um risco concreto com um experimento reproduzível, sem alarmismo. O ponto fraco, por enquanto, é a escala reduzida. Mas a mensagem se sustenta. Uma resposta plausível não prova que o sistema é seguro, e muitas empresas ainda testam agentes olhando apenas o texto. São necessários controles sobre os efeitos, não sobre as palavras. O tema se liga às obrigações do AI Act sobre cibersegurança.
Perguntas frequentes
O que é uma backdoor em um modelo open-weight?
É um comportamento oculto inserido nos pesos durante o treinamento. Permanece inativo até que surja uma condição precisa. No teste do CERT-AGID essa condição é um servidor MCP com um nome exato.
O modelo do teste é perigoso?
O modelo foi treinado de propósito pelos pesquisadores para demonstrar o mecanismo. A fonte não indica que exista um modelo malicioso disseminado. O artigo serve para mostrar que isso é tecnicamente possível.
Por que os testes iniciais não a encontram?
Porque sem o servidor trigger o modelo se comporta normalmente. Mesmo um nome muito parecido, como uma versão de backup, não ativa nada. Um teste precisa, portanto, variar nomes e ferramentas disponíveis.
É preciso atualizar os pesos para ativá-la?
Não. Segundo a AgID, a backdoor é ativada assim que a ferramenta correspondente é conectada, sem qualquer atualização dos pesos.
Como me proteger?
Limite as permissões dos agentes e as conexões de rede. Verifique os logs das ações e exija aprovação humana para operações sensíveis. São as orientações dadas pelo CERT-AGID.
O que acompanhar nos próximos meses sobre agentes com ferramentas MCP
O artigo abre um caminho de verificação mais do que encerra um caso. Vale acompanhar como mudam práticas e diretrizes.
- Veja se surgem testes com modelos maiores e com triggers diferentes do nome de um servidor.
- Mantenha uma lista dos modelos e adapters baixados, com origem e data, como para qualquer dependência.
- Leia os próximos artigos na seção Segurança do CERT-AGID e compare-os com a sua forma de testar agentes.



