
 Ing. Calogero Bono
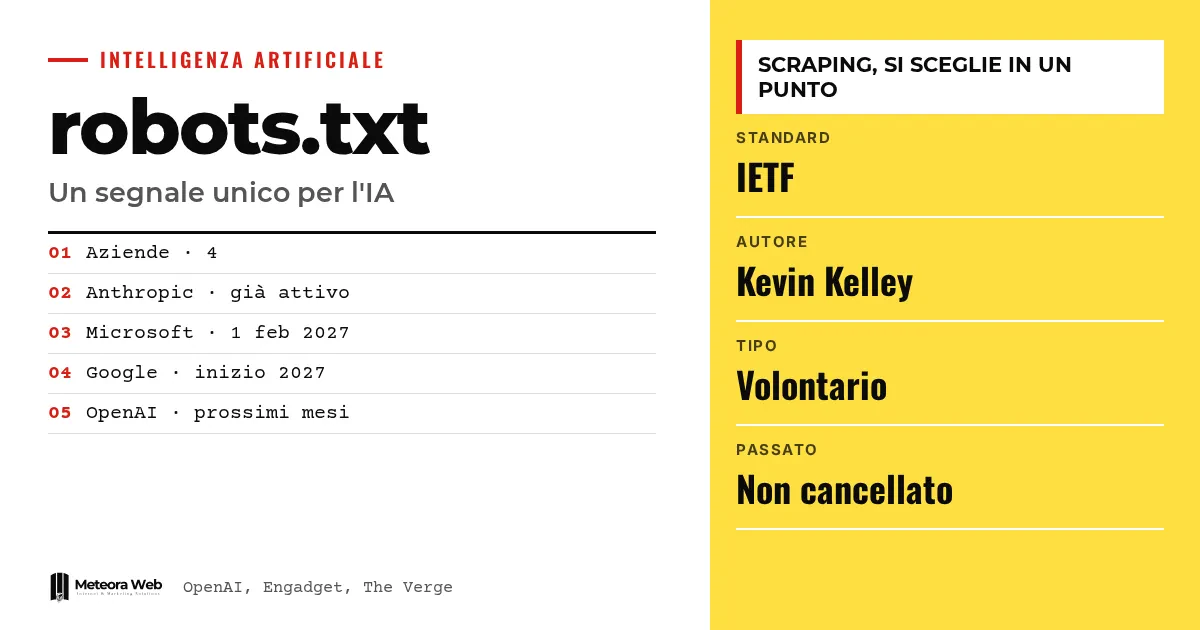
OpenAI、Google、Microsoft和Anthropic宣布,将遵守robots.txt文件中的一个通用信号。网站借此声明其内容能否用于训练生成式AI。过去你必须逐一指明每个爬虫,并为每家供应商单独设置规则。Anthropic已率先支持,其他公司将在未来几个月或2027年跟进。对于企业网站而言,这是一项简化,但也有明确的局限。
开始正题前的几个术语。 robots.txt是网站用来告诉自动程序哪些页面可以访问的文件。爬虫(crawler)是遍历页面以收集内容的程序。抓取(scraping)指自动收集内容。IETF是制定互联网标准的组织。用户代理(user agent)是爬虫向网站表明身份时使用的名称。
这个新的robots.txt信号包含什么?
据OpenAI介绍,这是一项自愿性的努力,让发布者和网站管理者能够同时向多家供应商传达同一种偏好。过去你需要识别每一个爬虫,并为其分别维护规则。
该提案出自Anthropic标准技术负责人Kevin Kelley,目前正在IETF讨论,The Verge对此有所报道。该信号位于robots.txt之中,而这个文件早已被用来说明哪些爬虫可以访问网站。
规则该怎么写?
据Engadget报道,网站管理者需要添加一个专用于AI训练的用户代理。报道中给出的示例如下。
- User-Agent __usage_ai-training
- Disallow /
- Allow /press-kit/
Allow一行允许保留特定部分开放,例如新闻资料夹。该屏蔽针对的是用于收集训练数据的爬虫。
各家公司何时正式生效?
Anthropic已经开始支持该指令。据Engadget报道,Microsoft将于2027年2月1日开始,Google则表示2027年初。OpenAI提到“未来几个月”,并承诺会发布包含细节的更新。
Meta方面,其通讯负责人Andy Stone表示支持这一通用信号,但并未说明是否会遵守。如果你想比较两家最知名的供应商,我们已经撰写过Claude与OpenAI的对比。
该信号会阻止搜索或已经完成的复制吗?
不会。据Engadget报道,这一新规则并不会阻止一般性的爬取,也不影响内容出现在Google搜索中。Google会将其理解为对Google-Extended用户代理的停止指令,该代理用于收集训练Gemini模型的材料。
它也不能追溯既往。如果某个页面已被收集,公司便已持有该内容。据The Verge报道,Microsoft将分别提供用于训练和用于grounding(即将模型与经过核实的来源相连)的独立控制选项,而网站仍会保留在Bing的结果中。
背景是爬虫对发布者造成的压力。The Verge提到了Really Simple Licensing标准,以及Cloudflare默认屏蔽AI爬虫的做法。若想了解这些机器人如何工作,可以阅读AI用于网页抓取。
需要了解的局限
该信号是自愿性的。报道中提到的是企业的承诺,而非对遵守情况的独立核查。该标准仍在IETF讨论中,OpenAI承诺会在之后再公布细节。目前尚不清楚Meta是否会采用,也不清楚未加入的企业的爬虫会如何反应。Google和Microsoft的时间表仍定在2027年。
对数字行业从业者的影响
如果你拥有企业网站、博客或网店,你将可以在一个地方决定自己的文本是否用于训练AI。关心内容排名的人,比如guest posting的从业者,需要评估是开放还是关闭访问权限。使用AI生成文本的人则有透明度义务,我们在AI法案第50条中有详细说明。针对单个爬虫的现有规则依然有效。
我们的看法
统一信号是一项实用的好消息,因为它减少了小网站原本承担的维护工作。不过它仍是一种依赖善意的机制,缺乏外部监督。Google和Microsoft要到2027年才跟进,意味着在很长一段时间内,单独设置的规则仍然必不可少。已经发布的内容也无法因此收回。我们认为这是有用的一步,但并非完整的保护。
常见问题
robots.txt中的新信号是强制性的吗?
不是,它是自愿性的。企业承诺会遵守,但该标准仍在IETF讨论中。
阻止训练会让网站从Google消失吗?
不会。据Engadget报道,该指令不影响网站在Google搜索中的展示。对Google而言,它等同于停止Google-Extended的抓取。
它会删除已经收集的内容吗?
不会。它只对未来的收集生效。如果某个页面已被获取,公司就已经拥有其内容。
Google和Microsoft何时开始生效?
2027年。Microsoft给出的日期是2027年2月1日,Google则是2027年初。Anthropic已经支持,OpenAI表示将在未来几个月内实现。
我需要更改已有的规则吗?
不需要。OpenAI明确表示,现有的控制措施依然有效并会被遵守。新信号是补充,而非替代。
在动robots.txt之前需要关注的时间节点
只有当供应商真正启用时,这个信号才会发挥作用。目前最好先等待细节公布,并做好准备。
- 检查你现有的robots.txt,记下你已经屏蔽了哪些AI爬虫,以便了解新信号在实际中会替代哪些内容。
- 关注OpenAI承诺的实施更新,以及Google和Microsoft在2027年的时间表。
- 提前决定网站哪些部分保持开放,例如新闻资料夹,哪些需要保护。



