
 Ing. Calogero Bono
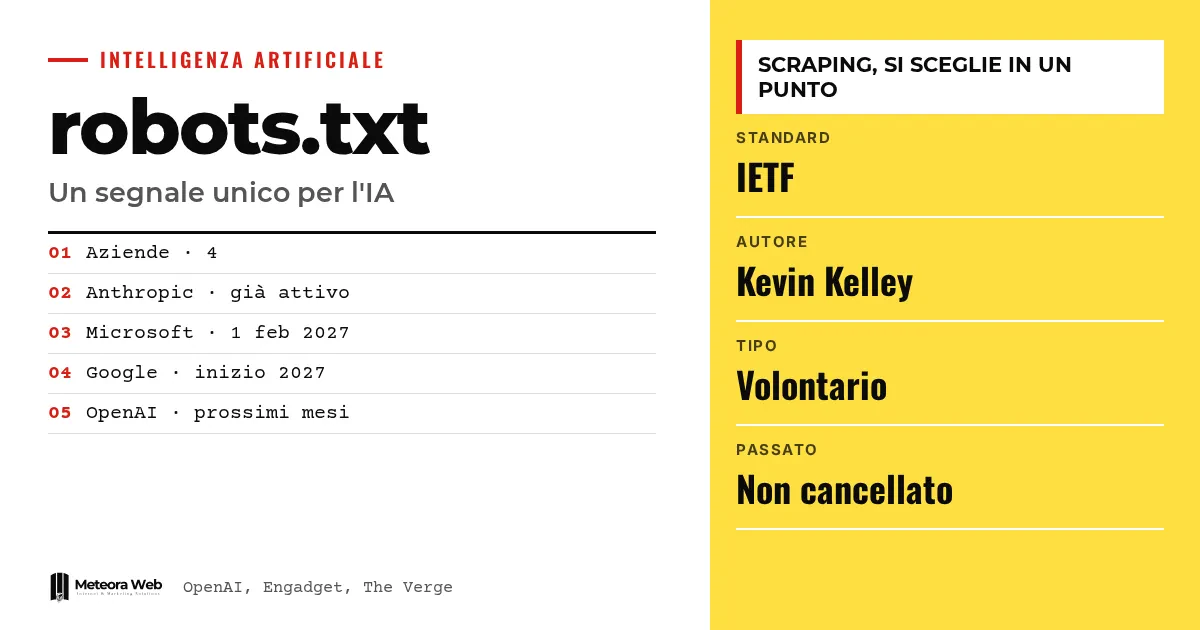
OpenAI, Google, Microsoft e Anthropic hanno annunciato che rispetteranno un segnale comune nel file robots.txt, con cui un sito dichiara se i suoi contenuti possono servire ad addestrare l'IA generativa. Finora bisognava indicare ogni crawler e scrivere regole separate per ogni fornitore. Anthropic lo supporta già, gli altri arriveranno nei prossimi mesi o nel 2027. Per chi gestisce un sito aziendale è una semplificazione, con limiti precisi.
Qualche termine, prima di entrare nei fatti. robots.txt è il file in cui un sito indica ai programmi automatici cosa possono visitare. Un crawler è il programma che scorre le pagine per raccoglierle. Lo scraping è la raccolta automatica di contenuti. L'IETF è l'organismo che definisce gli standard di internet. L'user agent è il nome con cui un crawler si presenta al sito.
Che cosa prevede il nuovo segnale in robots.txt?
Secondo OpenAI, si tratta di uno sforzo volontario che permette a editori e gestori di comunicare la stessa preferenza a più fornitori insieme. Prima si identificavano i singoli crawler e si mantenevano regole distinte per ciascuno.
La proposta è di Kevin Kelley, responsabile tecnico per gli standard di Anthropic, ed è in discussione all'IETF, come riporta The Verge. Il segnale vive dentro il robots.txt, già usato da tempo per indicare quali crawler possono visitare un sito.
Come si scrive la regola?
Secondo Engadget, il gestore aggiunge uno user agent dedicato all'addestramento dell'IA. L'esempio riportato è questo.
- User-Agent __usage_ai-training
- Disallow /
- Allow /press-kit/
La riga Allow permette di lasciare aperte parti specifiche, per esempio una cartella stampa. Il blocco riguarda i crawler pensati per raccogliere dati di addestramento.
Quando sarà attivo presso ciascuna azienda?
Anthropic ha già iniziato a supportare la direttiva. Microsoft, secondo Engadget, partirà il 1 febbraio 2027, mentre Google indica l'inizio del 2027. OpenAI parla di «prossimi mesi» e promette un nuovo aggiornamento con i dettagli.
Meta, per voce del responsabile comunicazione Andy Stone, ha espresso sostegno al segnale comune, ma non dice se lo rispetterà. Per chi confronta i due fornitori più noti, abbiamo già scritto di Claude e OpenAI.
Il segnale blocca anche la ricerca o le copie già fatte?
No. Secondo Engadget la nuova sezione non impedisce il crawling in generale né la comparsa dei contenuti nella ricerca di Google. Google la interpreterà come uno stop per l'user agent Google-Extended, che raccoglie materiali per addestrare i modelli Gemini.
Inoltre non cancella il passato. Se una pagina è già stata raccolta, il contenuto è già in possesso dell'azienda. Microsoft, secondo The Verge, offrirà controlli distinti per addestramento e per il grounding, cioè il collegamento del modello a fonti verificate, e i siti resteranno comunque nei risultati di Bing.
Il contesto è la pressione dei crawler sugli editori. The Verge cita lo standard Really Simple Licensing e il blocco predefinito dei crawler IA da parte di Cloudflare. Chi vuole capire come lavorano i bot può leggere AI per web scraping.
Limiti da conoscere
Il segnale è volontario. Le fonti riportano impegni delle aziende, non verifiche indipendenti sul rispetto della regola. Lo standard è ancora in discussione all'IETF e OpenAI ha promesso i dettagli solo più avanti. Non è chiaro se Meta l'adotterà, né come reagiranno i crawler di aziende che non hanno aderito. Le date di Google e Microsoft restano nel 2027.
Cosa cambia per chi lavora con il digitale
Se hai un sito aziendale, un blog o un negozio online, potrai decidere in un punto solo se i tuoi testi servono ad addestrare l'IA. Chi cura i contenuti per posizionarsi, come nel guest posting, dovrà valutare se aprire o chiudere l'accesso. Chi produce testi con l'IA ha invece obblighi di trasparenza, come spieghiamo sull'articolo 50 dell'AI Act. Le regole attuali per i singoli crawler restano valide.
Il nostro parere
Il segnale unico è una buona notizia pratica, perché riduce un lavoro di manutenzione che pesava sui piccoli siti. Resta però un meccanismo di buona volontà, senza controlli esterni. Il fatto che Google e Microsoft arrivino solo nel 2027 lascia un lungo periodo in cui le regole separate restano necessarie. E chi ha già pubblicato i contenuti non recupera nulla. Lo giudichiamo un passo utile, non una tutela completa.
Domande frequenti
Il nuovo segnale in robots.txt è obbligatorio?
No, è volontario. Le aziende si sono impegnate a rispettarlo, ma lo standard è ancora in discussione all'IETF.
Bloccare l'addestramento fa sparire il sito da Google?
No. Secondo Engadget la direttiva non impedisce la comparsa nella ricerca di Google. Per Google vale come stop a Google-Extended.
Cancella i contenuti già raccolti?
No. Vale solo per le raccolte future. Se una pagina è già stata acquisita, l'azienda ne ha già il contenuto.
Quando funzionerà con Google e Microsoft?
Nel 2027. Microsoft indica il 1 febbraio 2027, Google l'inizio dell'anno. Anthropic lo supporta già, OpenAI parla di prossimi mesi.
Devo cambiare le regole che ho già?
No. OpenAI precisa che i controlli attuali restano validi e rispettati. Il nuovo segnale si aggiunge, non li sostituisce.
Le date da seguire prima di toccare il robots.txt
Il segnale diventa utile quando i fornitori l'attivano davvero. Per ora conviene aspettare i dettagli e preparare il terreno.
- Controlla il robots.txt attuale e annota quali crawler IA hai già bloccato, così saprai cosa il nuovo segnale sostituirà nella pratica.
- Segui l'aggiornamento promesso da OpenAI sull'implementazione e le date di Google e Microsoft nel 2027.
- Decidi in anticipo quali sezioni del sito lasciare aperte, per esempio la cartella stampa, e quali proteggere.



