
 Ing. Calogero Bono
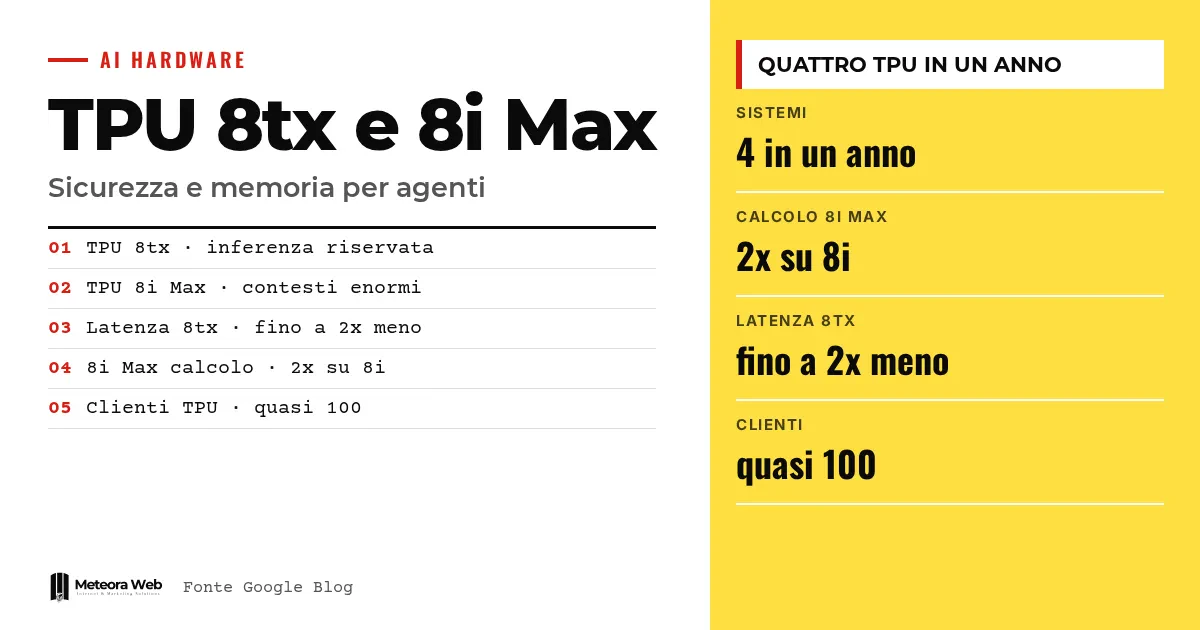
Google ha presentado TPU 8tx y TPU 8i Max, dos nuevos sistemas que completan la familia de aceleradores de octava generación. Se suman a TPU 8t y 8i, mostrados en abril durante Cloud Next. Según Google, es la primera vez que introduce cuatro sistemas TPU en un solo año. El objetivo son los agentes de IA, que manejan más datos y trabajan en más pasos, y las empresas que exigen más protección para los datos sensibles.
Algunos términos antes de entrar en los hechos. TPU es el procesador que Google diseña para la inteligencia artificial. Inferencia es la fase en la que un modelo ya entrenado responde a las peticiones. Ventana de contexto es la cantidad de texto que un modelo puede considerar de una vez. Computación confidencial protege los datos incluso mientras se procesan en memoria. HBM y SRAM son tipos de memoria rápida situados junto al chip.
¿Qué ha presentado Google?
En la publicación oficial de Google las novedades son dos sistemas. TPU 8tx está pensado para la inferencia segura y confidencial, y también es indicado para entrenamientos de pequeña escala. TPU 8i Max, en cambio, está pensado para ventanas de contexto muy grandes y para la máxima densidad de cálculo por rack.
En abril habían llegado TPU 8t, para el entrenamiento a gran escala, y TPU 8i, para el razonamiento en tiempo real. Google afirma hasta 2,7 veces más rendimiento en el entrenamiento y un 80% de mejor relación precio-rendimiento en la inferencia respecto a la generación anterior. La noticia también la recoge HDblog.
¿Cómo funciona TPU 8tx y para quién es?
Normalmente los datos están cifrados cuando se almacenan o viajan por la red, pero deben descifrarse en memoria durante el procesamiento. Google explica que TPU 8tx lleva la protección al nivel hardware, de modo que los datos sensibles y los pesos del modelo permanecen aislados incluso en uso. Usa el mismo silicio que TPU 8t, combinado con hosts con CPU AMD EPYC de quinta generación.
Además adopta la red Boardfly de baja latencia de TPU 8i. Según Google, la latencia baja hasta 2 veces respecto a TPU 8t, con una penalización de rendimiento casi nula. El público objetivo son empresas reguladas y gobiernos.
En el mismo sistema se puede entrenar y personalizar, por ejemplo hacer fine-tuning con datos privados, sin mover los datos entre clústeres distintos.
¿Qué es TPU 8i Max y qué resuelve?
Google lo relaciona con el problema del llamado muro de la memoria. Cuando decenas de agentes trabajan juntos sobre un código fuente completo o sobre horas de vídeo, el ancho de banda de memoria se convierte en el cuello de botella. La solución declarada es unir dos chips TPU 8i en un único package.
El resultado, siempre según Google, es el doble de cálculo, de SRAM y de ancho de banda HBM respecto a TPU 8i. Como en el mismo rack cabe el doble de silicio, los centros de datos pueden alojar más potencia por metro cuadrado y por vatio. El tema de la infraestructura es el mismo que el del centro de datos de Crusoe que Google compró en Wyoming.
¿Qué cambia para quienes desarrollan?
Google insiste en la accesibilidad. El mes pasado publicó en código abierto TorchTPU, de modo que el código PyTorch y los modelos de Hugging Face se ejecutan de forma nativa en las TPU, sin reescribir el código. Hay backends para motores de inferencia como vLLM y SGLang.
Un conjunto de agentes para TPU, en vista previa, se conecta con herramientas como Claude Code, Cursor y Google Antigravity para automatizar el arranque y diagnosticar cuellos de botella. Un XLA Serving Engine de código abierto permite entrenar en Python y servir en un runtime C++ sobre TPU, GPU y CPU.
En los benchmarks InferenceX y AgentX, Google afirma resultados de relación precio-rendimiento de vanguardia con su pila vLLM-TorchTPU. Son datos declarados por la empresa. Quien desarrolla sobre modelos puede empezar por nuestra guía a la Gemini API.
Límites que conviene conocer
Las cifras de rendimiento, latencia y relación precio-rendimiento son afirmaciones de Google, sin verificación independiente. En las fuentes que tenemos no aparecen precios, disponibilidad por región ni fechas de lanzamiento de los dos nuevos sistemas. El texto oficial que recibimos está cortado, así que algunas partes, como la gestión de la inactividad de los agentes, no son evaluables. Las actualizaciones de software prometidas podrían cambiar los resultados.
Qué cambia para quien trabaja con lo digital
Para casi todas las empresas de habla hispana nada inmediato, porque las TPU se usan a través de la nube de Google. La señal afecta sobre todo a quien maneja datos sensibles, por ejemplo en sanidad o finanzas. Una inferencia protegida también en memoria puede facilitar llevar un agente a datos confidenciales. Quien desarrolla software con PyTorch encuentra un camino más corto para probar estas máquinas sin reescribir el código. Conviene, eso sí, comparar los costes reales con los de las GPU. Si ya usas la familia Gemini de Google, estas máquinas son la base sobre la que funciona.
Nuestra opinión
La jugada es coherente. Google no busca solo el chip más rápido, sino vender sistemas a medida para cada fase del trabajo. La confidencialidad durante el uso es un argumento fuerte, porque frena a muchas empresas a la hora de confiar datos a los agentes. Pero sigue siendo un ecosistema cerrado, con ventajas que dependen de cifras de Google. Antes de entusiasmarse hacen falta precios y pruebas independientes. También conviene seguir el frente normativo, recordado en nuestra guía sobre la AI Act para desarrolladores.
Preguntas frecuentes
¿Qué diferencia hay entre TPU 8tx y TPU 8t?
TPU 8tx usa el mismo silicio que TPU 8t, pero está optimizado para la inferencia confidencial. Tiene la red de baja latencia de TPU 8i y protección hardware de los datos en uso. TPU 8t sigue siendo el sistema para el entrenamiento a gran escala.
¿Qué aporta TPU 8i Max frente a TPU 8i?
Duplica los recursos. Según Google, combina dos chips TPU 8i en un solo package, con el doble de cálculo, el doble de SRAM y el doble de ancho de banda HBM. Sirve para contextos muy grandes.
¿Puedo usar las TPU con mi código PyTorch?
Sí, según Google. TorchTPU es de código abierto y ejecuta código PyTorch y modelos de Hugging Face de forma nativa en las TPU, sin reescribir el código.
¿Cuántas TPU ha presentado Google este año?
Cuatro sistemas de octava generación. Son TPU 8t y 8i, mostrados en abril, más TPU 8tx y 8i Max. Google dice que nunca había ocurrido en un año.
¿Cuántos clientes usan las TPU?
Casi 100, según Google. Entre ellos hay laboratorios de frontera, empresas de trading, revendedores y universidades.
Precios, pruebas independientes y datos sensibles, qué vigilar en los próximos meses
El valor de estos sistemas se verá más allá de los comunicados. Importan la disponibilidad, los costes y las verificaciones externas.
- Revisa cuándo y dónde estarán disponibles TPU 8tx y 8i Max en la nube, y a qué precio.
- Busca pruebas independientes de los benchmarks InferenceX y AgentX, no solo los datos de Google.
- Si manejas datos confidenciales, evalúa con tu consultor qué garantías de computación confidencial necesitas de verdad.



