
 Ing. Calogero Bono
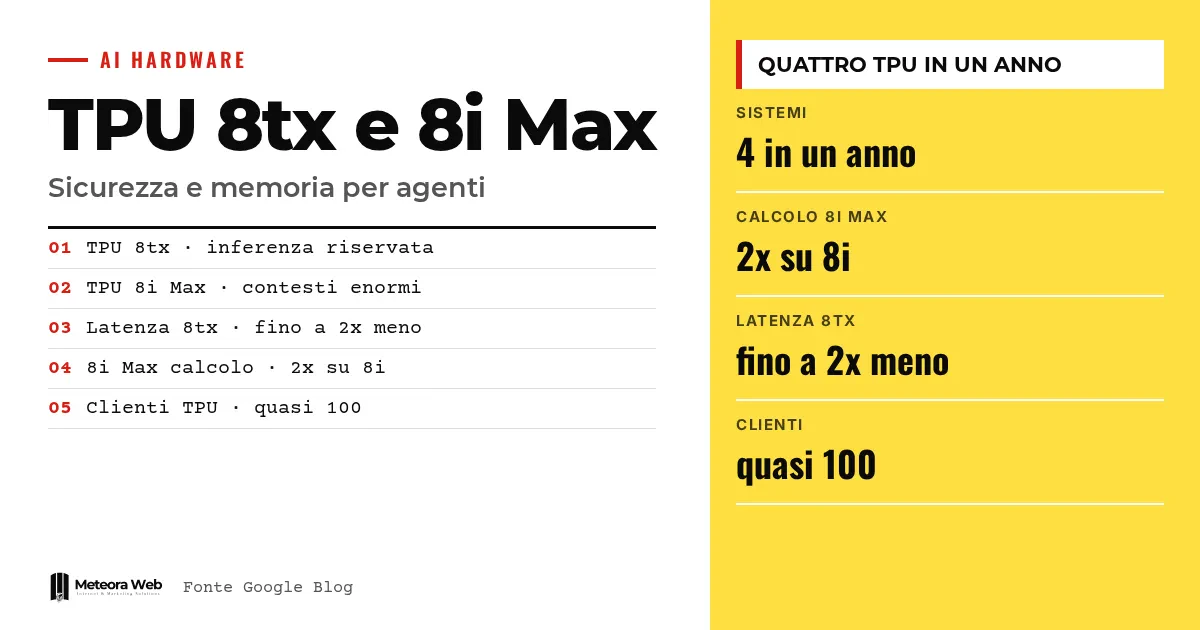
Google a présenté TPU 8tx et TPU 8i Max, deux nouveaux systèmes qui complètent la famille d'accélérateurs de huitième génération. Ils viennent s'ajouter à TPU 8t et 8i, dévoilés en avril lors de Cloud Next. Selon Google, c'est la première fois que l'entreprise introduit quatre systèmes TPU en une seule année. La cible, ce sont les agents IA, qui manipulent plus de données et enchaînent plusieurs étapes, ainsi que les entreprises qui réclament une meilleure protection de leurs données sensibles.
Quelques termes, avant d'entrer dans les faits. TPU est le processeur que Google conçoit pour l'intelligence artificielle. Inférence est la phase où un modèle déjà entraîné répond aux requêtes. Fenêtre de contexte est la quantité de texte qu'un modèle peut prendre en compte d'un seul coup. Confidential computing protège les données même pendant qu'elles sont traitées en mémoire. HBM et SRAM sont des types de mémoire rapide située près de la puce.
Qu'a présenté Google ?
Dans le billet officiel de Google, les nouveautés sont deux systèmes. TPU 8tx est conçu pour l'inférence sûre et confidentielle, et convient aussi à des entraînements à petite échelle. TPU 8i Max, lui, vise les très grandes fenêtres de contexte et la densité de calcul maximale par rack.
En avril, étaient arrivés TPU 8t, pour l'entraînement à grande échelle, et TPU 8i, pour le raisonnement en temps réel. Google annonce jusqu'à 2,7 fois plus de performances à l'entraînement et un rapport prix-performance meilleur de 80% en inférence par rapport à la génération précédente. L'information a aussi été reprise par HDblog.
Comment fonctionne TPU 8tx et à qui s'adresse-t-il ?
Habituellement, les données sont chiffrées au repos ou lorsqu'elles circulent sur le réseau, mais elles doivent être déchiffrées en mémoire pendant le traitement. Google explique que TPU 8tx apporte la protection au niveau matériel, de sorte que les données sensibles et les poids du modèle restent isolés même en cours d'usage. Il utilise le même silicium que TPU 8t, associé à des hôtes équipés de processeurs AMD EPYC de cinquième génération.
Il adopte en outre le réseau Boardfly à faible latence de TPU 8i. Selon Google, la latence baisse jusqu'à 2 fois par rapport à TPU 8t, avec une perte de performances presque nulle. La cible, ce sont les entreprises réglementées et les gouvernements.
Sur le même système, on peut entraîner et personnaliser, par exemple affiner un modèle sur des données privées, sans déplacer les données entre différents clusters.
Qu'est-ce que TPU 8i Max et quel problème résout-il ?
Google le relie au problème du dit mur de la mémoire. Lorsque des dizaines d'agents travaillent ensemble sur une base de code entière ou sur des heures de vidéo, la bande passante mémoire devient le goulot d'étranglement. La solution annoncée consiste à réunir deux puces TPU 8i dans un seul package.
Le résultat, toujours selon Google, est le double de calcul, de SRAM et de bande passante HBM par rapport à TPU 8i. Comme le double de silicium tient dans le même rack, les centres de données peuvent accueillir davantage de puissance par mètre carré et par watt. Le sujet de l'infrastructure est le même que celui du centre de données de Crusoe racheté par Google dans le Wyoming.
Que change-t-il pour les développeurs ?
Google insiste sur l'accessibilité. Le mois dernier, l'entreprise a publié en open source TorchTPU, de sorte que le code PyTorch et les modèles Hugging Face tournent nativement sur les TPU, sans réécriture. Des backends existent pour des moteurs d'inférence comme vLLM et SGLang.
Une suite d'agents pour TPU, en aperçu, se connecte à des outils comme Claude Code, Cursor et Google Antigravity pour automatiser le lancement et diagnostiquer les goulots d'étranglement. Un XLA Serving Engine open source permet d'entraîner en Python et de servir dans un runtime C++ sur TPU, GPU et CPU.
Sur les benchmarks InferenceX et AgentX, Google annonce des résultats de prix-performance à l'état de l'art avec sa pile vLLM-TorchTPU. Ce sont des données déclarées par l'entreprise. Si tu développes sur les modèles, tu peux partir de notre guide de l'API Gemini.
Limites à connaître
Les chiffres sur les performances, la latence et le rapport prix-performance sont des déclarations de Google, sans vérification indépendante. Les sources dont nous disposons ne mentionnent ni prix, ni disponibilité par région, ni dates de sortie des deux nouveaux systèmes. Le texte officiel que nous avons reçu est tronqué, donc certaines parties, comme la gestion de l'inactivité des agents, ne peuvent pas être évaluées. Les mises à jour logicielles promises pourraient modifier les résultats.
Ce qui change pour ceux qui travaillent avec le numérique
Pour presque toutes les entreprises italiennes, rien d'immédiat, car les TPU s'utilisent via le cloud de Google. Le signal concerne surtout ceux qui manipulent des données sensibles, par exemple dans la santé ou la finance. Une inférence protégée y compris en mémoire peut faciliter le déploiement d'un agent sur des données confidentielles. Si tu développes avec PyTorch, tu trouves un chemin plus court pour tester ces machines sans réécrire ton code. Il faut toutefois comparer les coûts réels avec ceux des GPU. Si tu utilises déjà la gamme Gemini de Google, ces machines sont la base sur laquelle elle tourne.
Notre avis
La démarche est cohérente. Google ne cherche pas seulement la puce la plus rapide, il vend des systèmes adaptés à chaque étape du travail. La confidentialité pendant l'usage est un argument fort, car elle freine beaucoup d'entreprises qui hésitent à confier leurs données aux agents. Il reste néanmoins un écosystème fermé, dont les avantages dépendent des chiffres de Google. Avant de s'enthousiasmer, il faut des prix et des tests indépendants. Le volet réglementaire mérite aussi d'être suivi, comme le rappelle notre guide sur l'AI Act pour les développeurs.
Questions fréquentes
Quelle est la différence entre TPU 8tx et TPU 8t ?
TPU 8tx utilise le même silicium que TPU 8t, mais il est optimisé pour l'inférence confidentielle. Il dispose de la mise en réseau à faible latence de TPU 8i et d'une protection matérielle des données en cours d'usage. TPU 8t reste le système destiné à l'entraînement à grande échelle.
Qu'apporte TPU 8i Max par rapport à TPU 8i ?
Il double les ressources. Selon Google, il combine deux puces TPU 8i dans un même package, avec un double calcul, une double SRAM et une double bande passante HBM. Il sert aux contextes très volumineux.
Puis-je utiliser les TPU avec mon code PyTorch ?
Oui, selon Google. TorchTPU est open source et fait tourner nativement du code PyTorch et des modèles Hugging Face sur les TPU, sans réécrire le code.
Combien de TPU Google a-t-il présentées cette année ?
Quatre systèmes de huitième génération. Il s'agit de TPU 8t et 8i, dévoilés en avril, auxquels s'ajoutent TPU 8tx et 8i Max. Google affirme que cela ne s'était jamais produit en une année.
Combien de clients utilisent les TPU ?
Près de 100, selon Google. Parmi eux figurent des laboratoires de pointe, des sociétés de trading, des revendeurs et des universités.
Prix, tests indépendants et données sensibles, ce qu'il faut surveiller dans les prochains mois
La valeur de ces systèmes se mesurera en dehors des communiqués. Ce qui compte, ce sont la disponibilité, les coûts et les vérifications externes.
- Vérifie quand et où TPU 8tx et 8i Max seront disponibles dans le cloud, et à quel prix.
- Cherche des tests indépendants sur les benchmarks InferenceX et AgentX, pas seulement les données de Google.
- Si tu traites des données confidentielles, évalue avec ton conseiller quelles garanties de confidential computing sont vraiment nécessaires.



