
 Ing. Calogero Bono
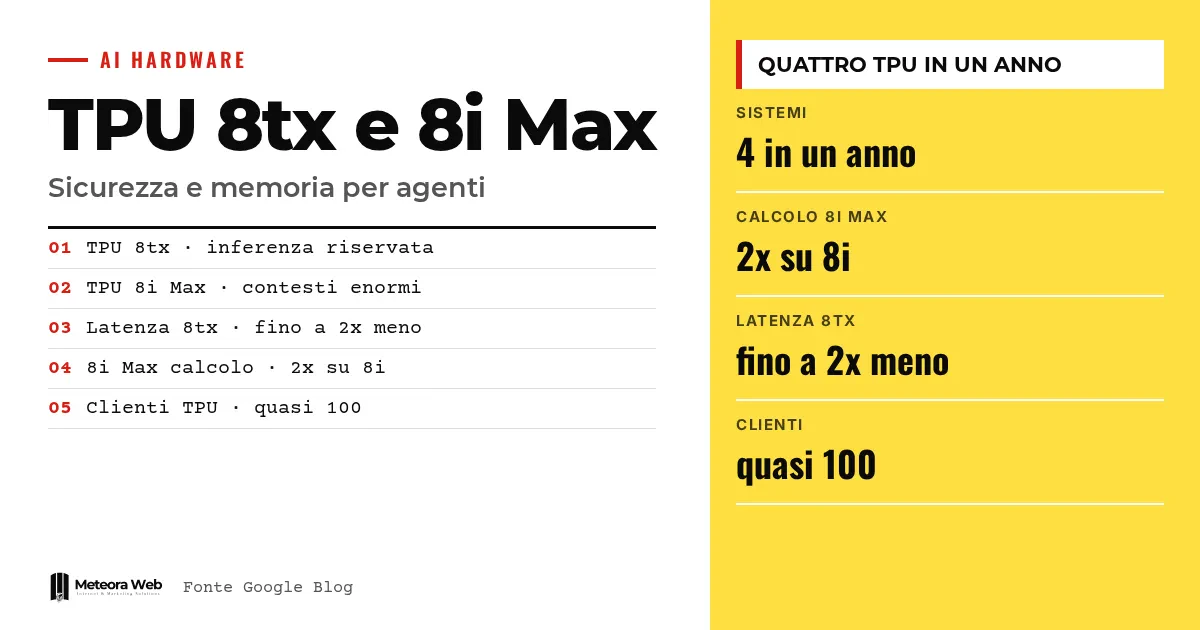
O Google apresentou a TPU 8tx e a TPU 8i Max, dois novos sistemas que completam a família de aceleradores de oitava geração. Eles se somam à TPU 8t e à 8i, mostradas em abril durante o Cloud Next. Segundo o Google, é a primeira vez que a empresa lança quatro sistemas TPU em um único ano. O alvo são os agentes de IA, que processam mais dados e trabalham em mais etapas, e as empresas que exigem mais proteção para dados sensíveis.
Alguns termos, antes de entrarmos nos fatos. TPU é o processador que o Google desenvolve para inteligência artificial. Inferência é a fase em que um modelo já treinado responde às solicitações. Janela de contexto é a quantidade de texto que um modelo consegue considerar de uma só vez. Computação confidencial protege os dados mesmo enquanto são processados na memória. HBM e SRAM são tipos de memória rápida posicionados perto do chip.
O que o Google apresentou?
No post oficial do Google, as novidades são dois sistemas. A TPU 8tx é voltada para inferência segura e confidencial, e também é indicada para treinamentos em pequena escala. A TPU 8i Max, por sua vez, foi pensada para janelas de contexto muito grandes e para a máxima densidade de computação por rack.
Em abril tinham chegado a TPU 8t, para treinamento em larga escala, e a TPU 8i, para raciocínio em tempo real. O Google afirma até 2,7 vezes mais desempenho no treinamento e 80% de melhor relação preço-desempenho na inferência em comparação com a geração anterior. A notícia também foi repercutida pelo HDblog.
Como funciona a TPU 8tx e para quem serve?
Normalmente os dados são criptografados quando estão armazenados ou trafegam na rede, mas precisam ser descriptografados na memória durante o processamento. O Google explica que a TPU 8tx leva a proteção para o nível do hardware, de modo que dados sensíveis e pesos do modelo permanecem isolados mesmo em uso. Ela usa o mesmo silício da TPU 8t, combinado com hosts com CPUs AMD EPYC de quinta geração.
Além disso, adota a rede Boardfly de baixa latência da TPU 8i. Para o Google, a latência cai até 2 vezes em relação à TPU 8t, com uma perda de desempenho quase nula. O público-alvo são empresas reguladas e governos.
No mesmo sistema é possível treinar e personalizar, por exemplo fazer fine-tuning com dados privados, sem mover os dados entre clusters diferentes.
O que é a TPU 8i Max e que problema resolve?
O Google a relaciona ao chamado muro da memória. Quando dezenas de agentes trabalham juntos sobre um código-fonte inteiro ou horas de vídeo, a largura de banda da memória se torna o gargalo. A solução declarada é unir dois chips TPU 8i em um único package.
O resultado, sempre segundo o Google, é o dobro de computação, de SRAM e de largura de banda HBM em relação à TPU 8i. Como cabe o dobro de silício no mesmo rack, os data center podem abrigar mais potência por metro quadrado e por watt. O tema da infraestrutura é o mesmo do data center da Crusoe adquirido pelo Google em Wyoming.
O que muda para quem desenvolve?
O Google insiste na acessibilidade. No mês passado lançou em open source o TorchTPU, de modo que código PyTorch e modelos Hugging Face rodam de forma nativa nas TPUs, sem reescrever o código. Há backends para motores de inferência como vLLM e SGLang.
Um conjunto de agentes para TPU, em pré-visualização, se conecta a ferramentas como Claude Code, Cursor e Google Antigravity para automatizar a inicialização e diagnosticar gargalos. Um XLA Serving Engine open source permite treinar em Python e servir em um runtime C++ em TPU, GPU e CPU.
Nos benchmarks InferenceX e AgentX, o Google afirma resultados de relação preço-desempenho de ponta com sua pilha vLLM-TorchTPU. São dados divulgados pela própria empresa. Quem desenvolve sobre modelos pode começar pelo nosso guia da Gemini API.
Limites a conhecer
Os números de desempenho, latência e relação preço-desempenho são afirmações do Google, sem verificação independente. Nas fontes que temos não há preços, disponibilidade por região nem datas de lançamento dos dois novos sistemas. O texto oficial que recebemos está truncado, por isso algumas partes, como o gerenciamento da ociosidade dos agentes, não podem ser avaliadas. As atualizações de software prometidas podem mudar os resultados.
O que muda para quem trabalha com tecnologia
Para quase todas as empresas brasileiras, nada de imediato, porque as TPUs são usadas pela nuvem do Google. O sinal é relevante para quem lida com dados sensíveis, como saúde ou finanças. Uma inferência protegida inclusive na memória pode facilitar levar um agente a dados confidenciais. Quem desenvolve software com PyTorch encontra um caminho mais curto para testar essas máquinas sem reescrever o código. Vale, porém, comparar os custos reais com os das GPUs. Se você já usa a linha Gemini do Google, essas máquinas são a base onde ela roda.
Nossa opinião
A jogada é coerente. O Google não busca apenas o chip mais rápido, vende sistemas sob medida para cada etapa do trabalho. A confidencialidade durante o uso é um argumento forte, pois freia muitas empresas que hesitam em entregar dados aos agentes. Continua, porém, sendo um ecossistema fechado, com vantagens que dependem dos números do próprio Google. Antes de se empolgar, são necessários preços e testes independentes. Também vale acompanhar o front regulatório, lembrado no nosso guia sobre o AI Act para desenvolvedores.
Perguntas frequentes
Qual é a diferença entre a TPU 8tx e a TPU 8t?
A TPU 8tx usa o mesmo silício da TPU 8t, mas é otimizada para inferência confidencial. Tem a rede de baixa latência da TPU 8i e proteção de dados em uso no nível do hardware. A TPU 8t continua sendo o sistema para treinamento em larga escala.
O que a TPU 8i Max faz a mais do que a TPU 8i?
Ela dobra os recursos. Segundo o Google, combina dois chips TPU 8i em um único package, com o dobro de computação, de SRAM e de largura de banda HBM. Serve para contextos muito grandes.
Consigo usar as TPUs com meu código PyTorch?
Sim, segundo o Google. O TorchTPU é open source e faz código PyTorch e modelos Hugging Face rodarem de forma nativa nas TPUs, sem reescrever o código.
Quantas TPUs o Google apresentou este ano?
Quatro sistemas de oitava geração. São a TPU 8t e a 8i, mostradas em abril, mais a TPU 8tx e a 8i Max. O Google diz que nunca tinha acontecido em um único ano.
Quantos clientes usam as TPUs?
Quase 100, segundo o Google. Entre eles estão laboratórios de fronteira, empresas de trading, revendedores e universidades.
Preços, testes independentes e dados sensíveis, o que acompanhar nos próximos meses
O valor desses sistemas vai aparecer além dos comunicados. Importam a disponibilidade, os custos e as verificações externas.
- Verifique quando e onde a TPU 8tx e a 8i Max ficam disponíveis na nuvem e a que preço.
- Procure testes independentes nos benchmarks InferenceX e AgentX, não apenas os dados do Google.
- Se você lida com dados confidenciais, avalie com seu consultor quais garantias de computação confidencial são realmente necessárias.



