
 Ing. Calogero Bono
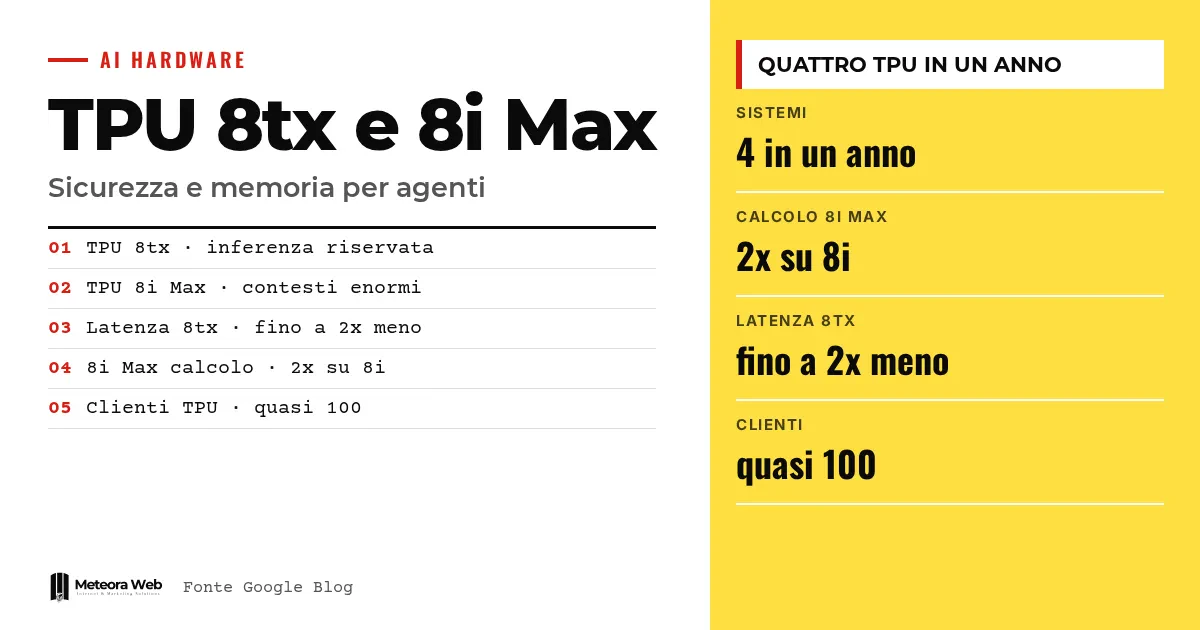
Google heeft TPU 8tx en TPU 8i Max gepresenteerd, twee nieuwe systemen die de familie van versnellers van de achtste generatie aanvullen. Ze komen naast TPU 8t en 8i, die in april tijdens Cloud Next werden getoond. Volgens Google is het de eerste keer dat het in één jaar vier TPU-systemen introduceert. Het doel zijn AI-agenten, die meer gegevens verwerken en over meerdere stappen werken, en bedrijven die meer bescherming voor gevoelige gegevens vragen.
Enkele termen, voordat we de feiten induiken. TPU is de processor die Google ontwerpt voor kunstmatige intelligentie. Inferentie is de fase waarin een al getraind model op verzoeken antwoordt. Contextvenster is de hoeveelheid tekst die een model in één keer kan overwegen. Confidential computing beschermt gegevens ook terwijl ze in het geheugen worden verwerkt. HBM en SRAM zijn soorten snel geheugen dicht bij de chip.
Wat heeft Google gepresenteerd?
In de officiële post van Google zijn de nieuwkomers twee systemen. TPU 8tx is bedoeld voor veilige en vertrouwelijke inferentie, en is ook geschikt voor training op kleine schaal. TPU 8i Max is bedoeld voor zeer grote contextvensters en de hoogste rekendichtheid per rack.
In april waren TPU 8t gekomen, voor training op grote schaal, en TPU 8i, voor redeneren in realtime. Google zegt tot 2,7 keer meer prestaties bij training en 80% betere prijs-prestatieverhouding bij inferentie ten opzichte van de vorige generatie. Het nieuws werd ook opgepikt door HDblog.
Hoe werkt TPU 8tx en voor wie is het bedoeld?
Gegevens zijn meestal versleuteld wanneer ze worden opgeslagen of over het netwerk reizen, maar moeten in het geheugen worden ontsleuteld tijdens de verwerking. Google legt uit dat TPU 8tx de bescherming naar de hardwarelaag brengt, zodat gevoelige gegevens en modelgewichten ook tijdens gebruik geïsoleerd blijven. Het gebruikt dezelfde silicium als TPU 8t, gecombineerd met hosts met AMD EPYC-cpu's van de vijfde generatie.
Het past ook het netwerk Boardfly met lage latentie van TPU 8i toe. Volgens Google daalt de latentie tot 2 keer ten opzichte van TPU 8t, met bijna geen prestatieverlies. De doelgroep zijn gereguleerde bedrijven en overheden.
Op hetzelfde systeem kun je trainen en personaliseren, bijvoorbeeld fine-tunen op privégegevens, zonder gegevens tussen verschillende clusters te verplaatsen.
Wat is TPU 8i Max en welk probleem lost het op?
Google koppelt het aan het zogenoemde geheugenmuur-probleem. Wanneer tientallen agenten samen werken aan een volledige broncode of uren video, wordt de geheugenbandbreedte het knelpunt. De aangekondigde oplossing is het samenvoegen van twee TPU 8i-chips in één package.
Het resultaat is volgens Google het dubbele aan rekenkracht, SRAM en HBM-bandbreedte ten opzichte van TPU 8i. Omdat er in hetzelfde rack twee keer zoveel silicium past, kunnen datacenters meer vermogen per vierkante meter en per watt huisvesten. Het thema van infrastructuur is hetzelfde als bij het datacenter van Crusoe in Wyoming dat Google heeft overgenomen.
Wat verandert er voor ontwikkelaars?
Google benadrukt toegankelijkheid. Vorige maand heeft het TorchTPU als open source uitgebracht, zodat PyTorch-code en Hugging Face-modellen native op TPU's draaien zonder de code te herschrijven. Er zijn backends voor inferentie-engines zoals vLLM en SGLang.
Een suite van agenten voor TPU's, in preview, koppelt aan tools als Claude Code, Cursor en Google Antigravity om het opstarten te automatiseren en knelpunten te diagnosticeren. Een open source XLA Serving Engine laat je trainen in Python en serveren in een C++-runtime op TPU's, GPU's en cpu's.
Op de InferenceX- en AgentX-benchmarks claimt Google state-of-the-art prijs-prestatieresultaten met zijn vLLM-TorchTPU-stack. Dit zijn door het bedrijf zelf opgegeven gegevens. Wie met modellen ontwikkelt, kan starten met onze gids voor de Gemini API.
Beperkingen om te kennen
De cijfers over prestaties, latentie en prijs-prestatieverhouding zijn verklaringen van Google, zonder onafhankelijke verificatie. In de bronnen die we hebben staan geen prijzen, beschikbaarheid per regio of releasedata van de twee nieuwe systemen. De officiële tekst die we hebben ontvangen is afgekapt, dus sommige delen, zoals het beheer van inactieve agenten, zijn niet te beoordelen. De beloofde softwareupdates kunnen de resultaten veranderen.
Wat verandert er voor wie met digitale technologie werkt
Voor vrijwel alle Nederlandse en Belgische bedrijven verandert er op korte termijn niets, omdat TPU's via de cloud van Google worden gebruikt. Het signaal is vooral relevant voor wie gevoelige gegevens verwerkt, bijvoorbeeld in de zorg of de financiële sector. Inferentie die ook in het geheugen beschermd is, kan het makkelijker maken een agent op vertrouwelijke gegevens in te zetten. Wie software met PyTorch ontwikkelt, krijgt een kortere weg om deze machines uit te proberen zonder de code te herschrijven. Vergelijk de echte kosten wel met die van GPU's. Als je al de Gemini-lijn van Google gebruikt, draaien deze machines eronder.
Ons oordeel
De zet is consistent. Google zoekt niet alleen de snelste chip, maar verkoopt systemen op maat voor elke fase van het werk. Beveiliging tijdens het gebruik is een sterk argument, omdat het veel bedrijven ervan weerhoudt gegevens aan agenten toe te vertrouwen. Het blijft echter een gesloten ecosysteem, met voordelen die afhangen van cijfers van Google zelf. Voordat je enthousiast wordt, zijn prijzen en onafhankelijke tests nodig. Het regelgevende front verdient ook aandacht, zoals in onze gids over de AI Act voor ontwikkelaars.
Veelgestelde vragen
Wat is het verschil tussen TPU 8tx en TPU 8t?
TPU 8tx gebruikt dezelfde silicium als TPU 8t, maar is geoptimaliseerd voor beveiligde inferentie. Het heeft het netwerk met lage latentie van TPU 8i en hardwarebescherming van gegevens tijdens gebruik. TPU 8t blijft het systeem voor training op grote schaal.
Wat doet TPU 8i Max meer dan TPU 8i?
Het verdubbelt de middelen. Volgens Google combineert het twee TPU 8i-chips in één package, met dubbele rekenkracht, dubbel SRAM en dubbele HBM-bandbreedte. Het is bedoeld voor zeer grote contexten.
Kan ik TPU's gebruiken met mijn PyTorch-code?
Ja, volgens Google. TorchTPU is open source en laat PyTorch-code en Hugging Face-modellen native op TPU's draaien, zonder de code te herschrijven.
Hoeveel TPU's heeft Google dit jaar gepresenteerd?
Vier systemen van de achtste generatie. Dat zijn TPU 8t en 8i, die in april werden getoond, plus TPU 8tx en 8i Max. Google zegt dat dit in één jaar nog nooit is gebeurd.
Hoeveel klanten gebruiken TPU's?
Bijna 100, volgens Google. Daaronder zijn frontier-laboratoria, handelsbedrijven, wederverkopers en universiteiten.
Prijzen, onafhankelijke tests en gevoelige gegevens, waar je in de komende maanden op moet letten
De waarde van deze systemen zal zichtbaar worden buiten de persberichten. Beschikbaarheid, kosten en externe verificatie tellen.
- Controleer wanneer en waar TPU 8tx en 8i Max beschikbaar komen in de cloud en tegen welke prijs.
- Zoek naar onafhankelijke tests van de InferenceX- en AgentX-benchmarks, niet alleen naar de cijfers van Google.
- Als je vertrouwelijke gegevens verwerkt, bespreek dan met je adviseur welke garanties voor confidential computing echt nodig zijn.



