
 Ing. Calogero Bono
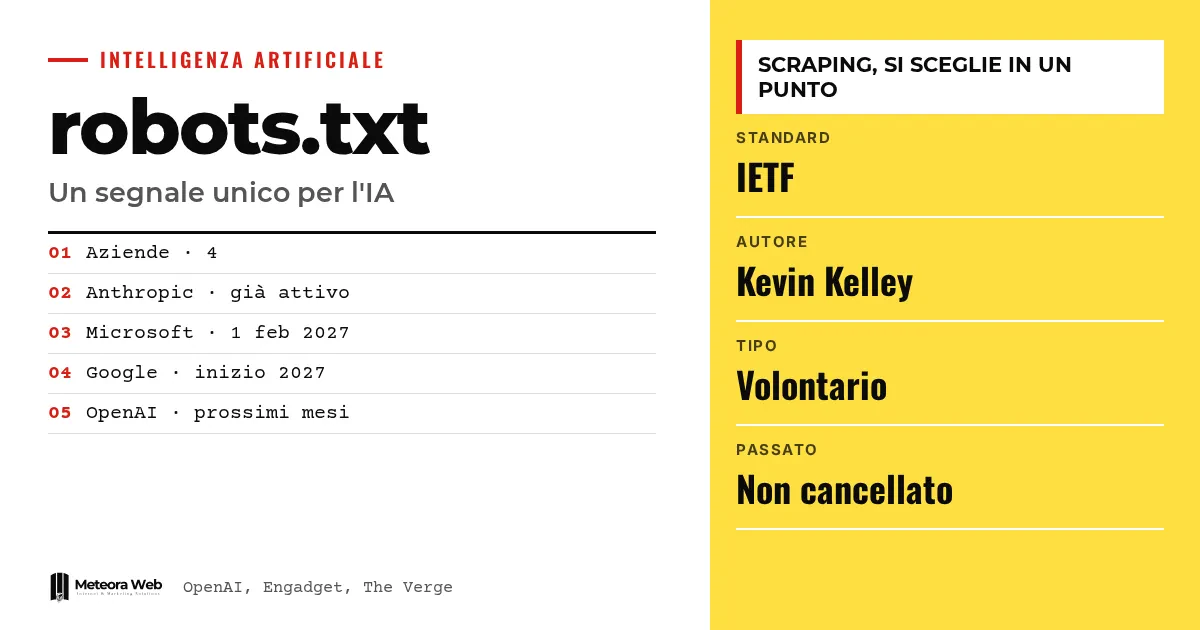
OpenAI, Google, Microsoft und Anthropic haben angekündigt, ein gemeinsames Signal in der Datei robots.txt zu respektieren, mit dem eine Website angibt, ob ihre Inhalte für das Training generativer KI verwendet werden dürfen. Bisher musstest du jeden Crawler einzeln nennen und für jeden Anbieter eigene Regeln schreiben. Anthropic unterstützt das Signal bereits, die anderen folgen in den nächsten Monaten oder im Jahr 2027. Für Betreiber einer Unternehmenswebsite ist das eine Vereinfachung, allerdings mit klaren Grenzen.
Ein paar Begriffe, bevor wir zu den Fakten kommen. robots.txt ist die Datei, in der eine Website automatischen Programmen mitteilt, was sie besuchen dürfen. Ein Crawler ist das Programm, das Seiten abläuft, um sie zu sammeln. Scraping ist das automatisierte Sammeln von Inhalten. Die IETF ist die Organisation, die Internetstandards festlegt. Der User Agent ist der Name, unter dem sich ein Crawler gegenüber einer Website ausweist.
Was sieht das neue Signal in robots.txt vor?
Laut OpenAI handelt es sich um eine freiwillige Initiative, mit der Verlage und Betreiber dieselbe Präferenz gleichzeitig an mehrere Anbieter übermitteln können. Bisher musste man einzelne Crawler identifizieren und für jeden eigene Regeln pflegen.
Der Vorschlag stammt von Kevin Kelley, dem technischen Standardverantwortlichen bei Anthropic, und wird bei der IETF diskutiert, wie The Verge berichtet. Das Signal lebt innerhalb der robots.txt, die schon seit Langem festlegt, welche Crawler eine Website besuchen dürfen.
Wie wird die Regel geschrieben?
Laut Engadget fügt der Betreiber einen eigenen User Agent für das KI-Training hinzu. Das berichtete Beispiel sieht so aus.
- User-Agent __usage_ai-training
- Disallow /
- Allow /press-kit/
Die Allow-Zeile erlaubt, bestimmte Bereiche offen zu lassen, etwa einen Pressebereich. Die Sperre betrifft Crawler, die zum Sammeln von Trainingsdaten gedacht sind.
Ab wann gilt es bei den einzelnen Unternehmen?
Anthropic hat bereits begonnen, die Vorgabe zu unterstützen. Microsoft startet laut Engadget am 1. Februar 2027, Google nennt den Beginn des Jahres 2027. OpenAI spricht von den «kommenden Monaten» und verspricht eine neue Aktualisierung mit den Details.
Meta hat durch seinen Kommunikationschef Andy Stone Unterstützung für das gemeinsame Signal geäußert, sagt aber nicht, ob es sich daran halten wird. Wer die beiden bekanntesten Anbieter vergleicht, findet dazu bei uns bereits einen Beitrag über Claude und OpenAI.
Blockiert das Signal auch die Suche oder bereits erstellte Kopien?
Nein. Laut Engadget verhindert der neue Abschnitt nicht das Crawling im Allgemeinen und auch nicht, dass Inhalte in der Google-Suche erscheinen. Google wird ihn als Stopp für den User Agent Google-Extended verstehen, der Material für das Training der Gemini-Modelle sammelt.
Außerdem löscht er nichts Vergangenes. Wenn eine Seite bereits erfasst wurde, liegt der Inhalt beim Unternehmen bereits vor. Microsoft bietet laut The Verge getrennte Kontrollen für das Training und für das Grounding an, also die Anbindung des Modells an geprüfte Quellen, und Websites bleiben in den Ergebnissen von Bing.
Hintergrund ist der Druck, den Crawler auf Verlage ausüben. The Verge verweist auf den Standard Really Simple Licensing und auf die standardmäßige Sperre von KI-Crawlern durch Cloudflare. Wer verstehen möchte, wie solche Bots arbeiten, kann unseren Beitrag zu KI für Web-Scraping lesen.
Grenzen, die du kennen solltest
Das Signal ist freiwillig. Die Berichte stützen sich auf Zusagen der Unternehmen, nicht auf unabhängige Prüfungen der Einhaltung. Der Standard wird bei der IETF noch diskutiert, und OpenAI hat Details erst für später zugesagt. Unklar ist, ob Meta ihn übernimmt und wie Crawler von Unternehmen reagieren, die nicht beigetreten sind. Die Termine für Google und Microsoft liegen weiterhin im Jahr 2027.
Was sich für alle ändert, die digital arbeiten
Wenn du eine Unternehmenswebsite, einen Blog oder einen Onlineshop betreibst, kannst du an einer einzigen Stelle festlegen, ob deine Texte für das KI-Training dienen dürfen. Wer Inhalte für bessere Rankings erstellt, etwa beim Guest Posting, sollte abwägen, ob er den Zugang öffnet oder schließt. Wer Texte mit KI erstellt, hat dagegen Transparenzpflichten, wie wir zu Artikel 50 des AI Act erklären. Die bestehenden Regeln für einzelne Crawler bleiben gültig.
Unsere Einschätzung
Das einheitliche Signal ist eine gute praktische Nachricht, weil es einen Pflegeaufwand verringert, der vor allem kleinere Websites belastete. Es bleibt jedoch ein Mechanismus auf freiwilliger Basis ohne externe Kontrolle. Dass Google und Microsoft erst 2027 nachziehen, bedeutet eine lange Übergangszeit, in der getrennte Regeln nötig bleiben. Und wer seine Inhalte bereits veröffentlicht hat, gewinnt nichts zurück. Wir halten das für einen nützlichen Schritt, nicht für einen vollständigen Schutz.
Häufig gestellte Fragen
Ist das neue Signal in robots.txt verpflichtend?
Nein, es ist freiwillig. Die Unternehmen haben sich verpflichtet, es zu respektieren, doch der Standard wird bei der IETF noch diskutiert.
Verschwindet meine Website aus Google, wenn ich das Training blockiere?
Nein. Laut Engadget verhindert die Anweisung nicht, dass deine Seite in der Google-Suche erscheint. Für Google gilt sie als Stopp für Google-Extended.
Werden bereits gesammelte Inhalte gelöscht?
Nein. Es gilt nur für künftige Sammlungen. Wenn eine Seite bereits erfasst wurde, besitzt das Unternehmen den Inhalt bereits.
Wann funktioniert es bei Google und Microsoft?
Im Jahr 2027. Microsoft nennt den 1. Februar 2027, Google den Jahresbeginn. Anthropic unterstützt es bereits, OpenAI spricht von den kommenden Monaten.
Muss ich meine bestehenden Regeln ändern?
Nein. OpenAI stellt klar, dass die aktuellen Kontrollen gültig bleiben und beachtet werden. Das neue Signal kommt hinzu, es ersetzt sie nicht.
Die Termine, die du vor einer Änderung der robots.txt im Blick behalten solltest
Das Signal wird nützlich, sobald die Anbieter es tatsächlich aktivieren. Vorerst lohnt es sich, auf die Details zu warten und die Grundlagen vorzubereiten.
- Prüfe deine aktuelle robots.txt und notiere, welche KI-Crawler du bereits blockiert hast, damit du weißt, was das neue Signal in der Praxis ersetzt.
- Verfolge die von OpenAI angekündigte Aktualisierung zur Umsetzung sowie die Termine von Google und Microsoft im Jahr 2027.
- Entscheide im Voraus, welche Bereiche deiner Website offen bleiben sollen, etwa der Pressebereich, und welche du schützen willst.



