
 Ing. Calogero Bono
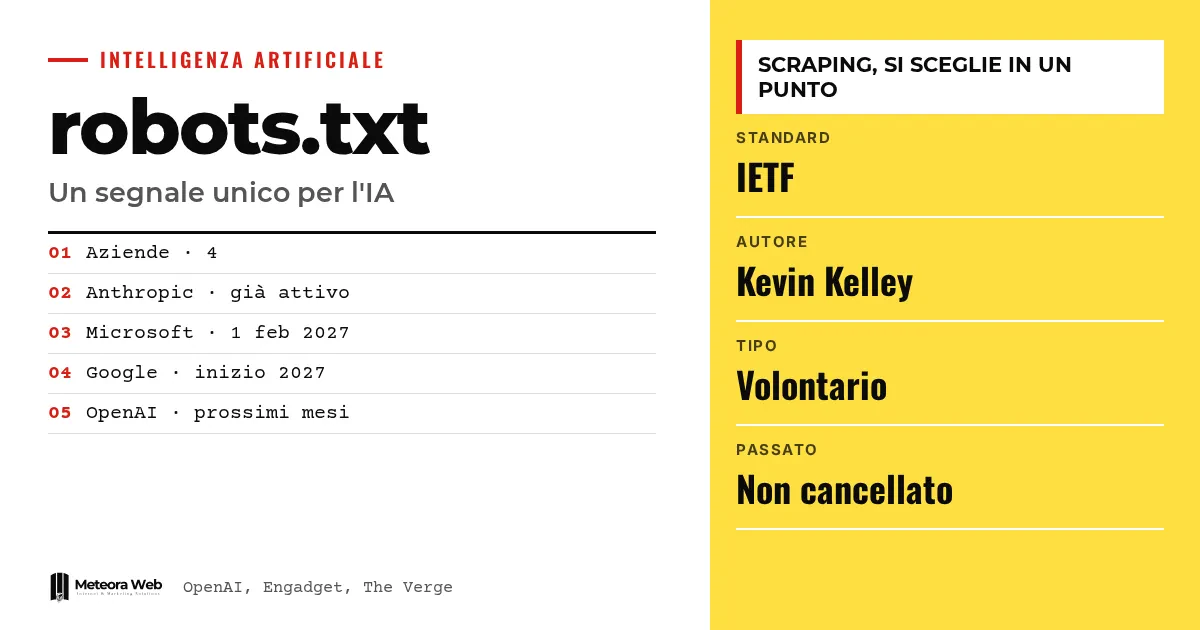
OpenAI, Google, Microsoft et Anthropic ont annoncé qu'ils respecteront un signal commun dans le fichier robots.txt, par lequel un site indique si ses contenus peuvent servir à entraîner l'IA générative. Jusqu'ici, il fallait citer chaque crawler et écrire des règles séparées pour chaque fournisseur. Anthropic le prend déjà en charge, les autres arriveront dans les prochains mois ou en 2027. Pour qui gère un site d'entreprise, c'est une simplification, avec des limites précises.
Quelques termes, avant d'entrer dans les faits. robots.txt est le fichier dans lequel un site indique aux programmes automatiques ce qu'ils peuvent visiter. Un crawler est le programme qui parcourt les pages pour les collecter. Le scraping est la collecte automatique de contenus. L'IETF est l'organisme qui définit les standards d'internet. Le user agent est le nom sous lequel un crawler se présente au site.
En quoi consiste le nouveau signal dans robots.txt ?
Selon OpenAI, il s'agit d'un effort volontaire qui permet aux éditeurs et aux gestionnaires de communiquer la même préférence à plusieurs fournisseurs à la fois. Auparavant, on identifiait les crawlers un à un et on maintenait des règles distinctes pour chacun.
La proposition vient de Kevin Kelley, responsable technique des standards chez Anthropic, et elle est en discussion à l'IETF, comme le rapporte The Verge. Le signal vit dans robots.txt, déjà utilisé depuis longtemps pour indiquer quels crawlers peuvent visiter un site.
Comment écrit-on la règle ?
Selon Engadget, le gestionnaire ajoute un user agent dédié à l'entraînement de l'IA. L'exemple rapporté est celui-ci.
- User-Agent __usage_ai-training
- Disallow /
- Allow /press-kit/
La ligne Allow permet de laisser ouvertes des parties précises, par exemple un dossier presse. Le blocage concerne les crawlers conçus pour collecter des données d'entraînement.
Quand sera-t-il actif chez chaque entreprise ?
Anthropic a déjà commencé à prendre en charge la directive. Microsoft, selon Engadget, démarrera le 1er février 2027, tandis que Google indique le début de 2027. OpenAI parle de « prochains mois » et promet une nouvelle mise à jour avec les détails.
Meta, par la voix de son responsable de la communication Andy Stone, a exprimé son soutien au signal commun, sans dire s'il le respectera. Pour qui compare les deux fournisseurs les plus connus, nous avons déjà écrit sur Claude et OpenAI.
Le signal bloque-t-il aussi la recherche ou les copies déjà faites ?
Non. Selon Engadget, la nouvelle section n'empêche ni le crawling en général ni l'apparition des contenus dans la recherche Google. Google l'interprétera comme un arrêt pour le user agent Google-Extended, qui collecte les matériaux pour entraîner les modèles Gemini.
Il n'efface pas non plus le passé. Si une page a déjà été collectée, le contenu est déjà en possession de l'entreprise. Microsoft, selon The Verge, proposera des contrôles distincts pour l'entraînement et pour le grounding, c'est-à-dire le rattachement du modèle à des sources vérifiées, et les sites resteront malgré tout dans les résultats de Bing.
Le contexte est la pression des crawlers sur les éditeurs. The Verge cite le standard Really Simple Licensing et le blocage par défaut des crawlers IA par Cloudflare. Pour comprendre comment travaillent les bots, tu peux lire AI per web scraping.
Limites à connaître
Le signal est volontaire. Les sources rapportent des engagements des entreprises, et non des vérifications indépendantes du respect de la règle. Le standard est encore en discussion à l'IETF et OpenAI n'a promis les détails que plus tard. On ignore si Meta l'adoptera, ni comment réagiront les crawlers des entreprises qui n'ont pas adhéré. Les dates de Google et Microsoft restent fixées en 2027.
Ce qui change pour qui travaille avec le numérique
Si tu as un site d'entreprise, un blog ou une boutique en ligne, tu pourras décider en un seul endroit si tes textes servent à entraîner l'IA. Qui soigne ses contenus pour se positionner, comme dans le guest posting, devra évaluer s'il ouvre ou ferme l'accès. Qui produit des textes avec l'IA a en revanche des obligations de transparence, comme nous l'expliquons à propos de l'article 50 de l'AI Act. Les règles actuelles pour les crawlers individuels restent valables.
Notre avis
Le signal unique est une bonne nouvelle pratique, car il réduit un travail de maintenance qui pesait sur les petits sites. Il reste cependant un mécanisme de bonne volonté, sans contrôles extérieurs. Le fait que Google et Microsoft n'arrivent qu'en 2027 laisse une longue période où les règles séparées restent nécessaires. Et ceux qui ont déjà publié leurs contenus ne récupèrent rien. Nous le jugeons un pas utile, mais pas une protection complète.
Questions fréquentes
Le nouveau signal dans robots.txt est-il obligatoire ?
Non, il est volontaire. Les entreprises se sont engagées à le respecter, mais le standard est encore en discussion à l'IETF.
Bloquer l'entraînement fait-il disparaître le site de Google ?
Non. Selon Engadget, la directive n'empêche pas l'apparition dans la recherche Google. Pour Google, elle vaut comme arrêt de Google-Extended.
Efface-t-il les contenus déjà collectés ?
Non. Cela ne vaut que pour les collectes futures. Si une page a déjà été acquise, l'entreprise en possède déjà le contenu.
Quand fonctionnera-t-il avec Google et Microsoft ?
En 2027. Microsoft indique le 1er février 2027, Google le début de l'année. Anthropic le prend déjà en charge, OpenAI parle des prochains mois.
Dois-je modifier les règles que j'ai déjà ?
Non. OpenAI précise que les contrôles actuels restent valables et respectés. Le nouveau signal s'ajoute, il ne les remplace pas.
Les dates à suivre avant de toucher au robots.txt
Le signal devient utile lorsque les fournisseurs l'activent réellement. Pour l'instant, mieux vaut attendre les détails et préparer le terrain.
- Vérifie ton robots.txt actuel et note quels crawlers IA tu as déjà bloqués, pour savoir ce que le nouveau signal remplacera concrètement.
- Suis la mise à jour promise par OpenAI sur l'implémentation ainsi que les dates de Google et Microsoft en 2027.
- Décide à l'avance quelles sections de ton site laisser ouvertes, par exemple le dossier presse, et lesquelles protéger.



