
 Ing. Calogero Bono
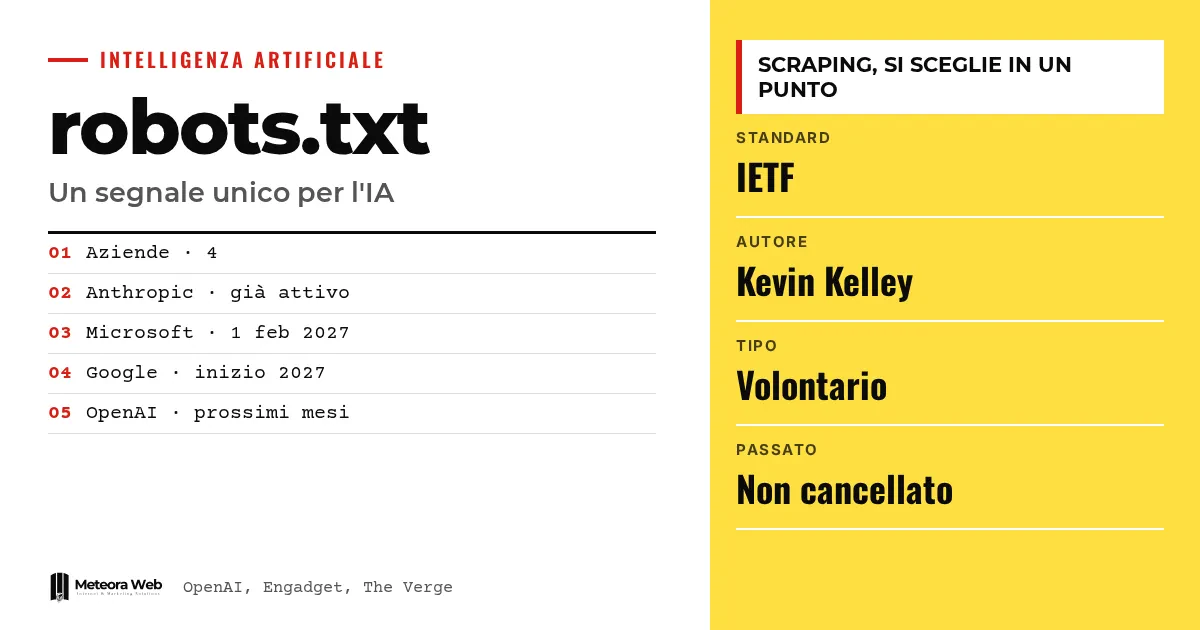
OpenAI、Google、Microsoft、Anthropicは、サイトが生成AIの学習にコンテンツを使ってよいかを宣言する、robots.txt内の共通シグナルを尊重すると発表しました。これまでは、クローラーごとに指定し、提供会社ごとに別々のルールを書く必要がありました。Anthropicはすでに対応しており、他社は今後数か月以内、または2027年に対応する予定です。企業サイトの管理者にとっては手間が減りますが、いくつかの明確な制約があります。
用語の説明 robots.txtは、サイトが自動プログラムに対して、どのページを訪問してよいかを指定するファイルです。クローラーは、ページをたどって情報を収集するプログラムです。スクレイピングは、コンテンツを自動で収集することです。IETFは、インターネットの標準を定める団体です。user agentは、クローラーがサイトに対して名乗る名前です。
新しいシグナルはrobots.txtで何を定めるのか。
OpenAIによると、これは任意の取り組みであり、出版社や管理者が同じ希望を複数の提供会社にまとめて伝えられるようにするものです。これまでは個々のクローラーを特定し、それぞれ別のルールを管理する必要がありました。
この提案はAnthropicの技術標準責任者であるKevin Kelleyによるもので、IETFで検討中です。The Vergeが報じています。このシグナルは、どのクローラーがサイトを訪問できるかを示すために以前から使われているrobots.txtの中に置かれます。
ルールはどのように書くのか。
Engadgetによると、管理者はAI学習専用のuser agentを追加します。報じられている例は次のとおりです。
- User-Agent __usage_ai-training
- Disallow /
- Allow /press-kit/
Allowの行で、プレスキットのフォルダなど特定の部分を開放しておけます。ブロックの対象は、学習データの収集を目的としたクローラーです。
各社では、いつから有効になるのか。
Anthropicはすでにこの指定への対応を始めています。Engadgetによると、Microsoftは2027年2月1日から開始し、Googleは2027年初めを示しています。OpenAIは「今後数か月以内」としており、詳細を示す更新を約束しています。
Metaは、広報責任者Andy Stoneを通じて共通シグナルへの支持を表明していますが、尊重するかどうかは明らかにしていません。最も知られた二社を比較したい方は、すでにClaudeとOpenAIについて書いた記事をご覧ください。
このシグナルで検索や既存のコピーは遮断されるのか。
いいえ。Engadgetによると、この新しい指定はクロールそのものや、Googleの検索結果へのコンテンツの掲載を妨げません。Googleは、Gemini向けのモデル学習用の素材を収集するuser agentであるGoogle-Extendedを止める指示として扱います。
また、過去の収集は取り消されません。すでに取得されたページは、企業がその内容をすでに保有しています。The Vergeによると、Microsoftは学習とグラウンディング、つまり検証済みの情報源とモデルを結びつける用途を分けた個別の制御を提供する予定で、サイトはBingの検索結果に残ります。
背景にあるのは、クローラーによる出版社への負担です。The VergeはReally Simple Licensingという標準や、CloudflareがAIクローラーをデフォルトでブロックしていることに言及しています。ボットの仕組みを理解したい方は、AIによるWebスクレイピングをご覧ください。
知っておくべき制約
このシグナルは任意です。報道されているのは各社の約束であり、ルールが守られているかどうかを第三者が検証したわけではありません。標準はまだIETFで検討中で、OpenAIは詳細を後日あらためて示すとしています。Metaが採用するかどうか、また参加していない企業のクローラーがどう反応するかも不明です。GoogleとMicrosoftの開始時期は2027年のままです。
デジタル業務への影響
企業サイト、ブログ、オンラインショップを運営している場合、テキストをAIの学習に使わせるかどうかを一か所で決められるようになります。ゲストポストなどで検索順位を狙っている場合は、アクセスを開くか閉じるかを検討する必要があるでしょう。AIでテキストを作成している場合は、AI法のアーティクル50による透明性の義務があります。現在の個別クローラー向けのルールは、引き続き有効です。
編集部の見解
共通シグナルは、特に小規模サイトにとって、管理の手間を減らす実用的な良いニュースです。ただし、外部からの検証がない善意に基づく仕組みであることに変わりはありません。GoogleとMicrosoftが2027年まで対応しないため、それまでは個別のルールが引き続き必要です。また、すでに公開されたコンテンツについては、この仕組みで取り戻せるものはありません。有益な一歩ではあるものの、完全な保護とは言えないと考えます。
よくある質問
robots.txtの新しいシグナルは必須ですか。
いいえ、任意です。各社は尊重すると約束していますが、標準はまだIETFで検討中です。
学習を遮断すると、サイトがGoogleの検索から消えますか。
いいえ。Engadgetによると、この指定はGoogleの検索結果への掲載を妨げません。Googleでは、Google-Extendedを止める指示として扱われます。
すでに収集されたコンテンツは削除されますか。
いいえ、削除されません。今後の収集にのみ適用されます。すでに取得されたページは、企業がその内容をすでに保有しています。
GoogleとMicrosoftではいつから機能しますか。
2027年です。Microsoftは2027年2月1日、Googleは2027年初めとしています。Anthropicはすでに対応しており、OpenAIは今後数か月以内と説明しています。
今の設定を変更する必要はありますか。
いいえ。OpenAIは、現在の制御設定も引き続き有効で尊重されると説明しています。新しいシグナルは追加されるもので、既存の設定に取って代わるものではありません。
robots.txtに触れる前に確認しておきたい日付
このシグナルは、各提供会社が実際に有効にして初めて役立ちます。現時点では詳細を待ちつつ、準備を進めておくのが良いでしょう。
- 現在のrobots.txtを確認し、すでにブロックしているAIクローラーを書き留めておきましょう。新しいシグナルが実際に何を置き換えるのかが分かります。
- OpenAIが約束している実装の詳細と、GoogleおよびMicrosoftの2027年の開始時期を追いかけましょう。
- プレスキットのフォルダなど、どのセクションを開放しておき、どこを保護するかを事前に決めておきましょう。



