
 Ing. Calogero Bono
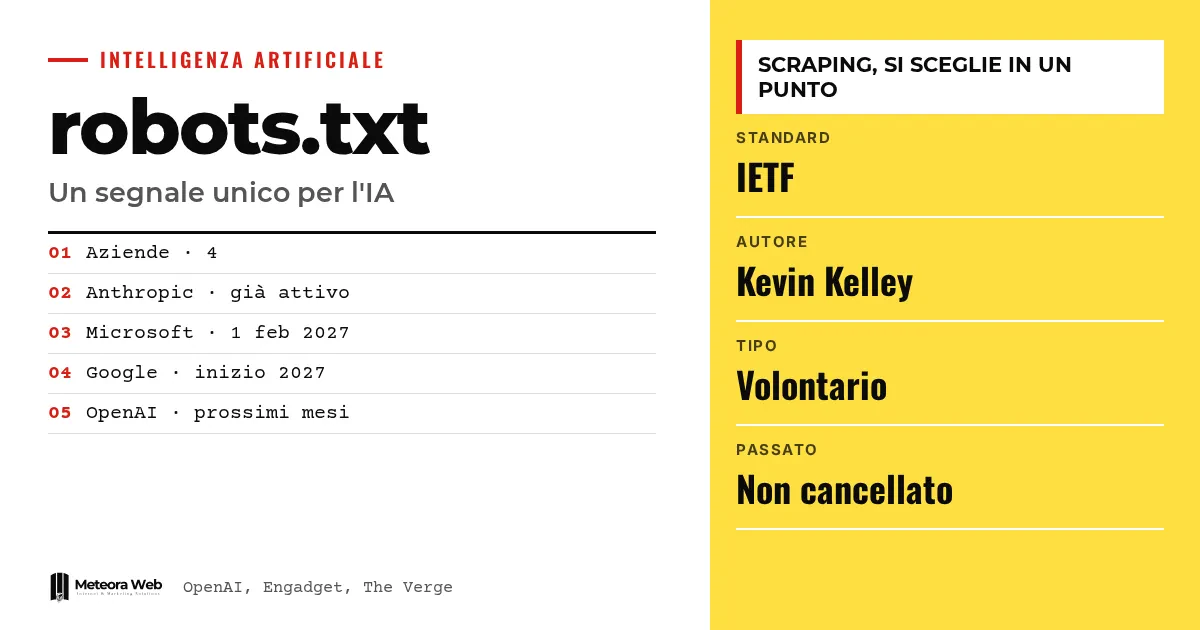
OpenAI, Google, Microsoft y Anthropic han anunciado que respetarán una señal común en el archivo robots.txt, con la que un sitio declara si sus contenidos pueden servir para entrenar la IA generativa. Hasta ahora había que indicar cada crawler y escribir reglas separadas para cada proveedor. Anthropic ya lo admite, los demás llegarán en los próximos meses o en 2027. Para quien gestiona una web empresarial es una simplificación, con límites precisos.
Algunos términos, antes de entrar en los hechos. robots.txt es el archivo en el que un sitio indica a los programas automáticos qué pueden visitar. Un crawler es el programa que recorre las páginas para recopilarlas. El scraping es la recopilación automática de contenidos. El IETF es el organismo que define los estándares de internet. El user agent es el nombre con el que un crawler se presenta al sitio.
¿Qué establece la nueva señal en robots.txt?
Según OpenAI, se trata de un esfuerzo voluntario que permite a editores y gestores comunicar la misma preferencia a varios proveedores a la vez. Antes se identificaba a cada crawler y se mantenían reglas distintas para cada uno.
La propuesta es de Kevin Kelley, responsable técnico de estándares en Anthropic, y está en debate en el IETF, como recoge The Verge. La señal vive dentro de robots.txt, ya usado desde hace tiempo para indicar qué crawlers pueden visitar un sitio.
¿Cómo se escribe la regla?
Según Engadget, el gestor añade un user agent dedicado al entrenamiento de la IA. El ejemplo recogido es este.
- User-Agent __usage_ai-training
- Disallow /
- Allow /press-kit/
La línea Allow permite dejar abiertas partes concretas, por ejemplo una carpeta de prensa. El bloqueo afecta a los crawlers pensados para recopilar datos de entrenamiento.
¿Cuándo estará activo en cada empresa?
Anthropic ya ha empezado a admitir la directiva. Microsoft, según Engadget, arrancará el 1 de febrero de 2027, mientras que Google indica el inicio de 2027. OpenAI habla de «próximos meses» y promete una actualización con los detalles.
Meta, a través de su responsable de comunicación Andy Stone, ha expresado apoyo a la señal común, pero no dice si la respetará. Para quien compara los dos proveedores más conocidos, ya hemos escrito sobre Claude y OpenAI.
¿La señal bloquea también la búsqueda o las copias ya hechas?
No. Según Engadget, la nueva sección no impide el rastreo en general ni la aparición de los contenidos en la búsqueda de Google. Google la interpretará como un stop para el user agent Google-Extended, que recopila materiales para entrenar los modelos Gemini.
Además, no borra el pasado. Si una página ya fue recopilada, el contenido ya está en poder de la empresa. Microsoft, según The Verge, ofrecerá controles distintos para el entrenamiento y para el grounding, es decir, la conexión del modelo con fuentes verificadas, y las webs seguirán apareciendo en los resultados de Bing.
El contexto es la presión de los crawlers sobre los editores. The Verge cita el estándar Really Simple Licensing y el bloqueo predeterminado de crawlers de IA por parte de Cloudflare. Quien quiera entender cómo trabajan los bots puede leer IA para web scraping.
Límites que conviene conocer
La señal es voluntaria. Las fuentes recogen compromisos de las empresas, no verificaciones independientes del cumplimiento de la regla. El estándar sigue en debate en el IETF y OpenAI ha prometido detalles solo más adelante. No está claro si Meta lo adoptará, ni cómo reaccionarán los crawlers de empresas que no se han adherido. Las fechas de Google y Microsoft siguen siendo 2027.
Qué cambia para quien trabaja con lo digital
Si tienes una web empresarial, un blog o una tienda online, podrás decidir en un solo punto si tus textos sirven para entrenar la IA. Quien cuida los contenidos para posicionarse, como en el guest posting, deberá valorar si abre o cierra el acceso. Quien produce textos con IA tiene en cambio obligaciones de transparencia, como explicamos en el artículo 50 de la AI Act. Las reglas actuales para cada crawler siguen siendo válidas.
Nuestra opinión
La señal única es una buena noticia práctica, porque reduce un trabajo de mantenimiento que pesaba sobre las webs pequeñas. Sin embargo, sigue siendo un mecanismo de buena voluntad, sin controles externos. Que Google y Microsoft lleguen solo en 2027 deja un largo periodo en el que las reglas separadas seguirán siendo necesarias. Y quien ya publicó sus contenidos no recupera nada. Lo consideramos un paso útil, no una protección completa.
Preguntas frecuentes
¿El nuevo señal en robots.txt es obligatorio?
No, es voluntario. Las empresas se han comprometido a respetarlo, pero el estándar sigue en debate en el IETF.
¿Bloquear el entrenamiento hace desaparecer mi web de Google?
No. Según Engadget, la directiva no impide que aparezca en la búsqueda de Google. Para Google equivale a un stop para Google-Extended.
¿Borra los contenidos ya recopilados?
No. Solo vale para las recopilaciones futuras. Si una página ya fue adquirida, la empresa ya tiene su contenido.
¿Cuándo funcionará con Google y Microsoft?
En 2027. Microsoft indica el 1 de febrero de 2027, Google a principios de año. Anthropic ya lo admite, OpenAI habla de los próximos meses.
¿Tengo que cambiar las reglas que ya tengo?
No. OpenAI precisa que los controles actuales siguen vigentes y se respetan. La nueva señal se suma, no los sustituye.
Las fechas que conviene seguir antes de tocar el robots.txt
La señal se vuelve útil cuando los proveedores la activan de verdad. Por ahora conviene esperar los detalles y preparar el terreno.
- Revisa tu robots.txt actual y anota qué crawlers de IA ya has bloqueado, para saber qué sustituirá en la práctica la nueva señal.
- Sigue la actualización prometida por OpenAI sobre su implementación y las fechas de Google y Microsoft en 2027.
- Decide de antemano qué secciones de tu web dejar abiertas, por ejemplo la carpeta de prensa, y cuáles proteger.



