
 Ing. Calogero Bono
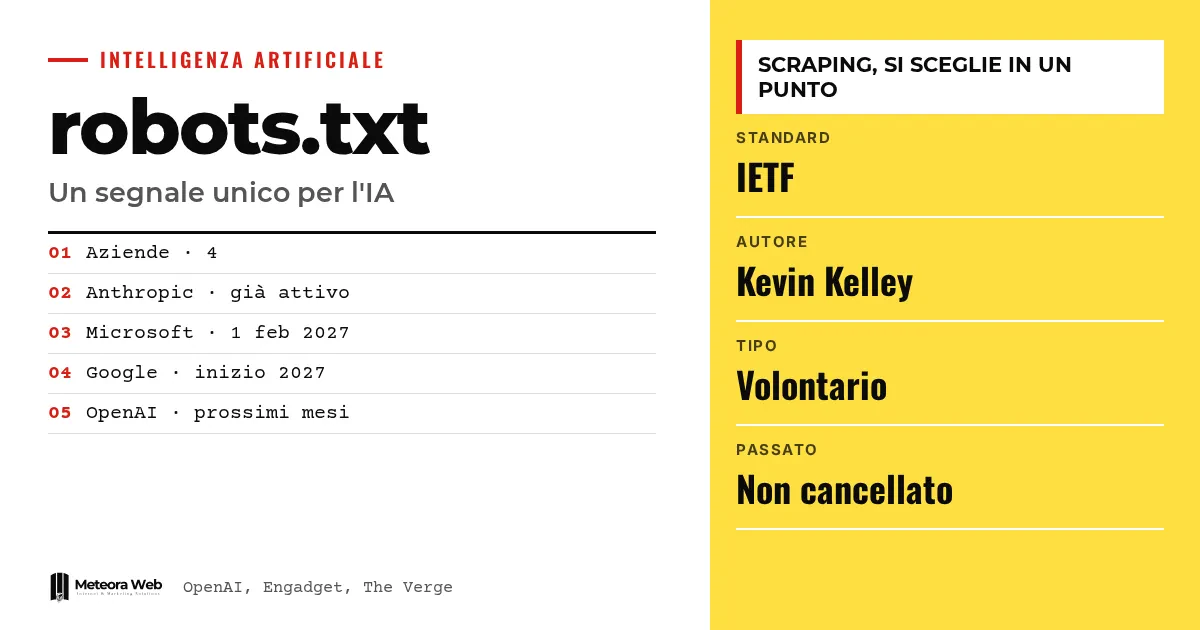
OpenAI, Google, Microsoft i Anthropic ogłosiły, że będą respektować wspólny sygnał w pliku robots.txt, dzięki któremu strona deklaruje, czy jej treści mogą posłużyć do trenowania generatywnej AI. Do tej pory trzeba było wskazać każdy crawler i pisać osobne reguły dla każdego dostawcy. Anthropic wspiera to już teraz, a pozostali dołączą w ciągu najbliższych miesięcy lub w 2027 roku. Dla kogoś, kto prowadzi firmową stronę, to uproszczenie, ale z precyzyjnymi ograniczeniami.
Kilka terminów, zanim przejdziemy do faktów. robots.txt to plik, w którym strona wskazuje programom automatycznym, co mogą odwiedzać. Crawler to program, który przegląda strony, aby je zebrać. Scraping to automatyczne zbieranie treści. IETF to organizacja, która opracowuje standardy internetu. User agent to nazwa, pod którą crawler przedstawia się stronie.
Na czym polega nowy sygnał w robots.txt?
Według OpenAI to dobrowolny wysiłek, który pozwala wydawcom i administratorom przekazać tę samą preferencję wielu dostawcom naraz. Wcześniej trzeba było identyfikować pojedyncze crawlery i utrzymywać odrębne reguły dla każdego z nich.
Propozycja pochodzi od Kevina Kelleya, odpowiedzialnego za standardy technyczne w Anthropic, i jest omawiana w IETF, jak podaje The Verge. Sygnał umieszczono w robots.txt, którego od dawna używa się do wskazywania, które crawlery mogą odwiedzać stronę.
Jak napisać tę regułę?
Według Engadgeta administrator dodaje user agent przeznaczony do trenowania AI. Oto przykład podany w źródle.
- User-Agent __usage_ai-training
- Disallow /
- Allow /press-kit/
Reguła Allow pozwala zostawić otwarte konkretne fragmenty, na przykład folder z materiałami prasowymi. Blokada dotyczy crawlerów zbierających dane do trenowania.
Kiedy sygnał zacznie działać w poszczególnych firmach?
Anthropic już zaczęło wspierać tę dyrektywę. Microsoft, według Engadgeta, ruszy 1 lutego 2027 roku, a Google podaje początek 2027 roku. OpenAI mówi o „najbliższych miesiącach” i obiecuje kolejną aktualizację ze szczegółami.
Meta, w osobie rzecznika Andy’ego Stone’a, wyraziła poparcie dla wspólnego sygnału, ale nie mówi, czy go będzie przestrzegać. Jeśli chcesz porównać dwóch najbardziej znanych dostawców, pisaliśmy już o Claude i OpenAI.
Czy sygnał blokuje też wyszukiwarkę lub kopie, które już powstały?
Nie. Według Engadgeta nowa sekcja nie uniemożliwia ogólnego crawlingu ani pojawiania się treści w wyszukiwarce Google. Google zinterpretuje ją jako zatrzymanie dla user agenta Google-Extended, który zbiera materiały do trenowania modeli Gemini.
Nie cofa też przeszłości. Jeśli strona została już zebrana, treść jest już w posiadaniu firmy. Microsoft, według The Verge, zaoferuje odrębne kontrole dla trenowania i dla groundingu, czyli łączenia modelu ze sprawdzonymi źródłami, a strony pozostaną w wynikach Bing.
Tło to presja crawlerów na wydawców. The Verge wspomina o standardzie Really Simple Licensing oraz o domyślnym blokowaniu crawlerów AI przez Cloudflare. Jeśli chcesz zrozumieć, jak działają boty, przeczytaj AI dla web scrapingu.
Ograniczenia, o których warto wiedzieć
Sygnał jest dobrowolny. Źródła mówią o zobowiązaniach firm, a nie o niezależnej weryfikacji ich przestrzegania. Standard jest wciąż omawiany w IETF, a OpenAI obiecało szczegóły dopiero później. Nie wiadomo, czy Meta go przyjmie ani jak zareagują crawlery firm, które nie dołączyły. Terminy dla Google i Microsoftu pozostają na 2027 rok.
Co zmienia się dla osób pracujących w cyfrowym świecie
Jeśli prowadzisz firmową stronę, blog lub sklep internetowy, będziesz mógł w jednym miejscu zdecydować, czy twoje teksty mogą służyć do trenowania AI. Ktoś, kto dba o treści pod kątem pozycjonowania, jak w przypadku guest postingu, będzie musiał ocenić, czy otworzyć, czy zamknąć dostęp. Osoby tworzące teksty z pomocą AI mają natomiast obowiązki przejrzystości, o czym piszemy w artykule o artykule 50 AI Act. Dotychczasowe reguły dla pojedynczych crawlerów nadal obowiązują.
Nasza opinia
Wspólny sygnał to dobra wiadomość praktyczna, bo zmniejsza pracę związaną z utrzymaniem reguł, która obciążała mniejsze strony. To jednak wciąż mechanizm oparty na dobrej woli, bez zewnętrznej kontroli. Fakt, że Google i Microsoft dołączą dopiero w 2027 roku, oznacza długi okres, w którym osobne reguły pozostaną potrzebne. Osoby, które już opublikowały treści, niczego nie odzyskają. Uważamy to za użyteczny krok, ale nie za pełną ochronę.
Często zadawane pytania
Czy nowy sygnał w robots.txt jest obowiązkowy?
Nie, jest dobrowolny. Firmy zobowiązały się go respektować, ale standard jest wciąż omawiany w IETF.
Czy blokada trenowania sprawi, że strona zniknie z Google?
Nie. Według Engadgeta ta dyrektywa nie uniemożliwia pojawiania się w wyszukiwarce Google. Dla Google działa jako zatrzymanie Google-Extended.
Czy usuwa treści, które zostały już zebrane?
Nie. Dotyczy tylko przyszłych pobrań. Jeśli strona została już pobrana, firma ma już jej treść.
Kiedy zacznie działać w Google i Microsoft?
W 2027 roku. Microsoft podaje 1 lutego 2027, a Google początek roku. Anthropic już to wspiera, a OpenAI mówi o najbliższych miesiącach.
Czy muszę zmienić reguły, które już mam?
Nie. OpenAI precyzuje, że obecne ustawienia pozostają ważne i będą respektowane. Nowy sygnał dochodzi do nich, a ich nie zastępuje.
Terminy, które warto śledzić, zanim dotkniesz robots.txt
Sygnał stanie się naprawdę użyteczny, gdy dostawcy faktycznie go wdrożą. Na razie warto poczekać na szczegóły i przygotować grunt.
- Sprawdź obecny robots.txt i zapisz, które crawlery AI już zablokowałeś, dzięki czemu będziesz wiedzieć, co nowy sygnał w praktyce zastąpi.
- Śledź zapowiedziany przez OpenAI aktualizacja dotycząca wdrożenia oraz terminy Google i Microsoftu w 2027 roku.
- Z góry zdecyduj, które sekcje strony zostawić otwarte, na przykład folder z materiałami prasowymi, a które chronić.



