Ing. Calogero Bono
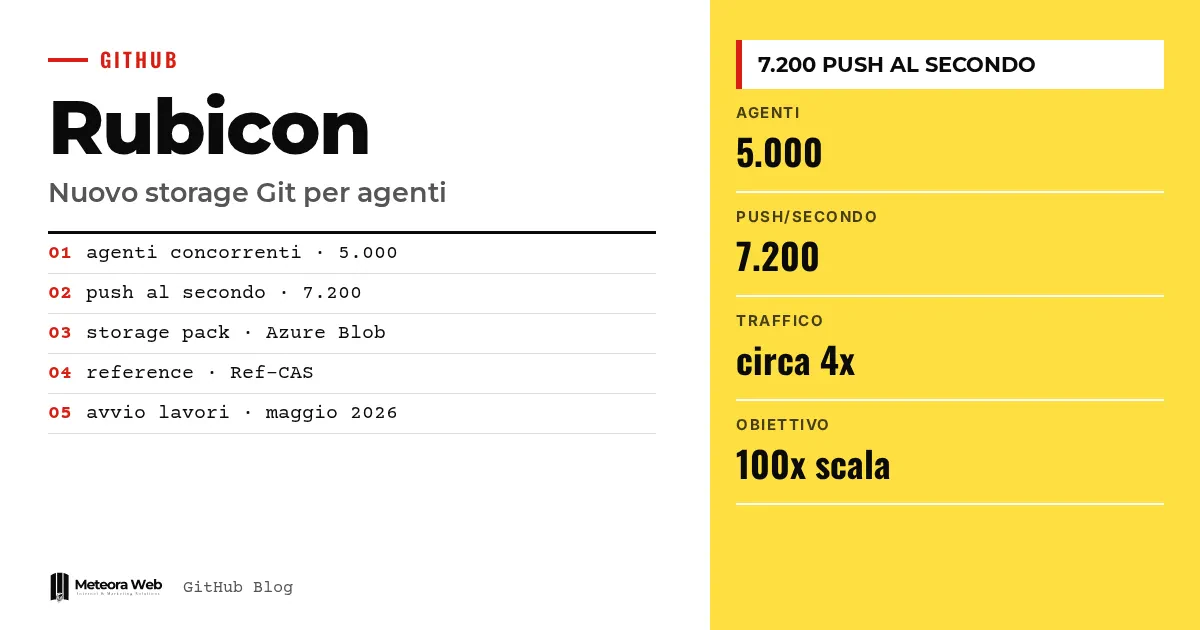
GitHub hat Rubicon beschrieben, die neue Git-Storage-Architektur, die auf der GitHub Universe angekündigt wurde. Laut dem Unternehmen hat sie in internen Tests 5.000 gleichzeitige Agenten auf einem Repository verkraftet, mit 7.200 Pushes pro Sekunde und Lesezugriffen mit niedriger Latenz. Das ist wichtig, weil Coding-Agenten die Last auf Repositories verändern, und was GitHub heute trägt, reicht vielleicht in einem Jahr nicht mehr.
Ein paar Begriffe, bevor es um die Fakten geht. Agent ist ein KI-Programm, das selbstständig Code schreibt und pusht. Reference ist der Zeiger auf einen Commit, ähnlich wie ein Branch. Pack ist die Datei, die Git-Objekte bündelt. Compare-and-swap ist eine Operation, die einen Wert nur dann aktualisiert, wenn ihn in der Zwischenzeit niemand verändert hat. Blob Storage ist der Objektspeicher-Dienst von Azure.
Was ist Rubicon und warum hat GitHub es gebaut?
Rubicon ist der Projektname, unter dem GitHub neu gestaltet hat, wie Git-Daten gespeichert und ausgeliefert werden. Laut dem Artikel von GitHub begann die Arbeit im Mai 2026, direkt nach der ersten Migration zu Azure.
Der Grund ist die Last. GitHub gibt an, dass die am stärksten genutzten Repositories heute höchstens Dutzende Schreibvorgänge pro Sekunde in kurzen Schüben verarbeiten. Mit Agenten, die parallel und dauerhaft arbeiten, erwartet das Unternehmen, dass dies innerhalb eines Jahres zum Dauerzustand wird. Deshalb hat es sich ein Ziel von mindestens zwei Größenordnungen mehr gesetzt.
Welche Skalierungsanforderungen hat GitHub festgelegt?
GitHub unterscheidet zwei Achsen. Die horizontale Skalierung betrifft viele Repositories, hier greifen bewährte Lösungen wie Partitionierung und lastabhängiges Routing. Die vertikale Skalierung betrifft ein einzelnes, sehr großes und stark genutztes Repository, und daher stammen fast alle Anforderungen.
Für ein einzelnes Repository muss die Architektur Tausende Schreibvorgänge pro Sekunde verkraften und mehrere Schreibknoten unterstützen. Sie muss außerdem die Commit-Latenz senken, weil ein Agent auf jeden Push wartet, bevor er den nächsten Schritt geht. Jeder Push erzeugt zudem weitere Lesezugriffe durch CI, Deployments und andere Agenten, und GitHub spricht von einem starken Verstärkungseffekt.
Als Beispiel nennt GitHub ein Repository, dessen Tagesverkehr sich zwischen März und Mai etwa vervierfacht hat.
Wie funktioniert die neue Architektur?
Der Grundgedanke ist, dass nur die Aktualisierung der References abgestimmt werden muss. Git-Objekte sind unveränderlich und über ihren Inhalt identifiziert, deshalb können mehrere Schreiber sie gemeinsam speichern. So lassen sich Speicherung, Anfragenbearbeitung und Wartung unabhängig voneinander skalieren.
Anfragen gehen an Spokes, das weiterhin für Routing und Lastverteilung zuständig ist. Darunter liegt eine neue Datenebene mit virtuellen Replikaten und flüchtiger Rechenleistung, deren lokale Festplatte nur ein wiederherstellbarer Cache ist. Der dauerhafte Zustand liegt an zwei Orten.
- Packs und Beschleunigungsdaten in Azure Blob Storage.
- References und die Liste der Packs (das Manifest) in Ref-CAS, einem replizierten Log-Dienst.
Ein Schreibvorgang indexiert das Pack, lädt es in Blob Storage hoch und führt eine einzige Transaktion in Ref-CAS aus. Ein Lesevorgang prüft die Version der References, lädt fehlende Packs nach und antwortet aus dem Cache. Die Verdichtung der Packs läuft auf getrennten Knoten, niemals auf den Replikaten.
Ändert sich etwas für alle, die täglich mit Git arbeiten?
Laut GitHub nicht. Git bleibt Git, Push, Fetch und Branches funktionieren wie gewohnt und mit denselben Schutzmechanismen. Die Änderung betrifft das Innenleben der Plattform und wird im laufenden Betrieb eingeführt.
Das Thema steht im Zusammenhang mit den Entwicklungen bei Git-Werkzeugen für Agenten, etwa dem Fall OpenAI übernimmt Pierre. Wer die Grundbefehle gut kennt, etwa mit Git bisect und blame, muss seine Gewohnheiten nicht umstellen.
Grenzen, die du kennen solltest
Die Zahlen zu 5.000 Agenten und 7.200 Pushes pro Sekunde stammen aus internen Tests, die GitHub selbst angibt, und sind nicht extern überprüft. Der vorliegende Text bricht ab, bevor die Details zu den zwei vertieften Komponenten kommen, daher kennen wir die technischen Kompromisse nicht. Vollständige Einführungsdaten für alle Repositories liegen nicht vor.
Was sich für alle ändert, die digital arbeiten
Für eine Agentur oder ein kleines Team ändert sich kurzfristig fast nichts. Der Punkt ist ein anderer. Wenn deine Abläufe Agenten mit vielen Pushes nutzen, rüstet GitHub auf, damit sie stabil laufen. Es lohnt sich trotzdem, die eigene Pipeline zu durchdenken, denn jeder Push erzeugt Folgelesezugriffe, wie auch im Vergleich von GitLab CI/CD und GitHub Actions beschrieben. Wer Plattformen für viele Kunden baut, kann das Prinzip übernehmen, Rechenleistung und Daten zu trennen, ein Thema, das dem Multi-Tenant-Ansatz nahe liegt.
Unsere Einschätzung
Rubicon ist ein ernsthaftes ingenieurtechnisches Projekt, und die Idee, nur die References zu koordinieren, ist elegant. Der Name verrät aber noch mehr. GitHub betrachtet die Last durch Agenten als Punkt ohne Umkehr und setzt sie als sicher voraus. Ob das Wachstum tatsächlich so eintritt oder ob synthetische Tests die reale Nutzung überschätzen, bleibt abzuwarten. Dafür braucht es unabhängige Daten und nicht nur die des Anbieters.
Häufige Fragen
Was ist Project Rubicon von GitHub?
Es ist die neue Git-Storage-Architektur von GitHub, angekündigt auf der GitHub Universe. Sie trennt Speicher und Rechenleistung und koordiniert nur die Aktualisierungen der References.
Wie viele Pushes pro Sekunde verkraftet sie?
In internen Tests gibt GitHub 7.200 Pushes pro Sekunde auf einem Repository an, bei 5.000 gleichzeitigen Agenten. Das sind Angaben des Unternehmens, die nicht von Dritten geprüft wurden.
Muss ich ändern, wie ich Git nutze?
Nein. Laut GitHub funktionieren Push, Fetch und Branches wie bisher, mit denselben Schutzmechanismen.
Wo werden die Daten gespeichert?
Die Packs liegen in Azure Blob Storage. References und die Liste der Packs liegen in Ref-CAS, einem replizierten Log-Dienst.
Warum braucht ein Repository mehrere Replikate?
Weil das Indexieren der Packs und die Prüfung der Objekt-Konnektivität viel CPU kostet. Mehrere Knoten verteilen die Arbeit und verbessern die Fehlertoleranz.
Worauf du achten solltest, wenn Rubicon auf alle Repositories kommt
Der eigentliche Test wird der Übergang von internen Zahlen zu echten Repositories sein. Darauf solltest du achten.
- Verfolge die nächsten Beiträge der GitHub-Serie zu den zwei vertieften Komponenten, um die Kompromisse zu verstehen.
- Prüfe in den kommenden Monaten, ob sich Push- und Fetch-Zeiten deiner Repositories verändern.
- Kontrolliere, ob GitHub Grenzwerte oder Nutzungsregeln für Agenten mit vielen parallelen Pushes veröffentlicht.