Ing. Calogero Bono
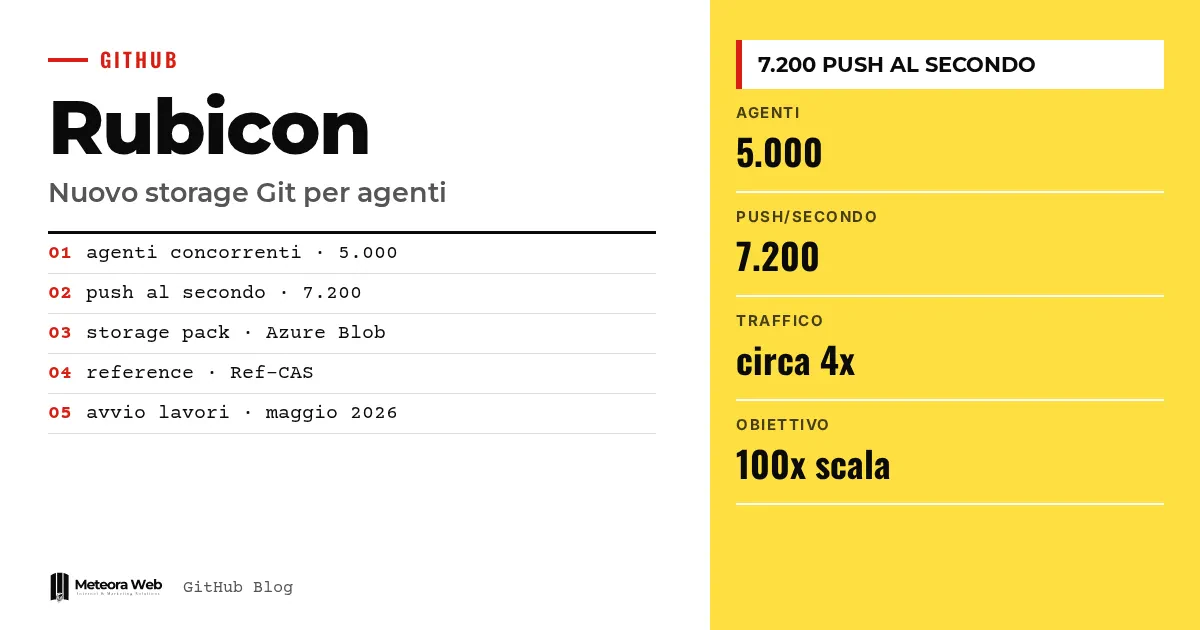
GitHub a décrit Rubicon, la nouvelle architecture de stockage Git annoncée lors de GitHub Universe. Selon l'entreprise, lors de tests internes elle a supporté 5 000 agents simultanés sur un même dépôt, avec 7 200 push par seconde et des lectures à faible latence. Cela compte parce que les agents de programmation modifient la charge des dépôts, et ce que GitHub encaisse aujourd'hui pourrait ne plus suffire dans un an.
Quelques termes, avant d'entrer dans les faits. Agent est un programme d'IA qui écrit du code et fait des push tout seul. Reference est le pointeur vers un commit, comme une branche. Pack est le fichier qui regroupe les objets Git. Compare-and-swap est une opération qui met à jour une valeur seulement si personne ne l'a modifiée entre-temps. Blob Storage est le service de stockage d'objets d'Azure.
Qu'est-ce que Rubicon et pourquoi GitHub l'a-t-il construit ?
Rubicon est le nom du projet avec lequel GitHub a repensé la façon de conserver et de servir les données Git. Selon l'article de GitHub, le travail a commencé en mai 2026, juste après la migration initiale vers Azure.
La raison est la charge. GitHub indique qu'aujourd'hui les dépôts les plus sollicités reçoivent au maximum quelques dizaines d'écritures par seconde, en courtes rafales. Avec des agents qui travaillent en parallèle et en continu, il s'attend à ce que cela devienne un rythme constant d'ici un an. C'est pourquoi il a fixé un objectif d'au moins deux ordres de grandeur supplémentaires.
Quelles exigences d'échelle GitHub a-t-il fixées ?
GitHub distingue deux axes. L'échelle horizontale concerne le grand nombre de dépôts, où les solutions déjà éprouvées restent valables, comme le partitionnement et le routage selon la charge. L'échelle verticale concerne un seul dépôt très volumineux et très sollicité, et c'est de là que viennent presque toutes les exigences.
Pour un seul dépôt, l'architecture doit accepter des milliers d'écritures par seconde et prendre en charge plusieurs nœuds d'écriture. Elle doit aussi réduire la latence des commits, car un agent attend chaque push avant l'étape suivante. Chaque push génère par ailleurs davantage de lectures, entre CI, déploiements et autres agents, et GitHub parle d'un fort effet d'amplification.
Un exemple cité est un dépôt dont le trafic quotidien a été multiplié par environ 4 entre mars et mai.
Comment fonctionne la nouvelle architecture ?
L'idée de départ est qu'un accord n'est nécessaire que pour la mise à jour des references. Les objets Git sont immuables et identifiés par leur contenu, donc plusieurs écrivains peuvent les enregistrer ensemble. Ainsi, stockage, service des requêtes et maintenance évoluent de façon indépendante.
Les requêtes arrivent à Spokes, qui continue de s'occuper du routage et de l'équilibrage. En dessous se trouve un nouveau plan de données, avec des répliques virtuelles, un calcul jetable dont le disque local n'est qu'un cache reconstructible. L'état durable se trouve à deux endroits.
- Les packs et les données d'accélération dans Azure Blob Storage.
- Les references et la liste des packs (le manifeste) dans Ref-CAS, un service de journal répliqué.
Une écriture indexe le pack, le charge sur Blob Storage et effectue une seule transaction sur Ref-CAS. Une lecture vérifie la version des references, télécharge les packs manquants et répond depuis le cache. La compaction des packs s'exécute sur des nœuds séparés, jamais sur les répliques.
Cela change-t-il quelque chose pour ceux qui utilisent Git au quotidien ?
Selon GitHub, non. Git reste Git, avec push, fetch et branches fonctionnant de la même manière et avec les mêmes protections. Le changement se fait sous le capot et est déployé pendant que la plateforme reste en service.
Le sujet rejoint ce qui se passe dans les outils Git pour les agents, comme avec OpenAI qui rachète Pierre. Ceux qui maîtrisent bien les commandes de base, par exemple avec Git bisect et blame, n'ont pas à changer leurs habitudes.
Limites à connaître
Les chiffres sur les 5 000 agents et les 7 200 push par seconde proviennent de tests internes annoncés par GitHub, sans vérification externe. Le texte fourni s'interrompt avant les détails sur les deux composants analysés en profondeur, on ne connaît donc pas les compromis techniques. Aucune date d'adoption complète pour tous les dépôts n'est disponible.
Ce qui change pour ceux qui travaillent avec le numérique
Pour une agence ou une petite équipe, dans l'immédiat presque rien. Le point est ailleurs. Si tes flux de travail utilisent des agents qui font beaucoup de push, GitHub se prépare à ce qu'ils tiennent. Il reste utile de réfléchir à ton propre pipeline, car chaque push génère des lectures en chaîne, comme le montre aussi la comparaison entre GitLab CI/CD et GitHub Actions. Ceux qui construisent des plateformes avec beaucoup de clients peuvent observer le principe de séparer calcul et données, un sujet proche du multi-tenant.
Notre avis
Rubicon est un projet d'ingénierie sérieux, et l'idée de ne coordonner que les references est élégante. Mais le nom dit aussi autre chose. GitHub considère la charge des agents comme un point de non-retour, et la tient pour acquise. Reste à voir si la croissance sera vraiment celle prévue ou si les tests synthétiques surestimeront l'usage réel. Il faudrait des données indépendantes, pas seulement celles du fournisseur.
Questions fréquentes
Qu'est-ce que Project Rubicon de GitHub ?
C'est la nouvelle architecture de stockage Git de GitHub, annoncée lors de GitHub Universe. Elle sépare stockage et calcul et ne coordonne que les mises à jour des references.
Combien de push par seconde supporte-t-elle ?
Lors de tests internes, GitHub annonce 7 200 push par seconde sur un dépôt, avec 5 000 agents simultanés. Ce sont des données de l'entreprise, non vérifiées par des tiers.
Dois-je changer ma façon d'utiliser Git ?
Non. Selon GitHub, push, fetch et branches fonctionnent comme avant, avec les mêmes protections.
Où sont stockées les données ?
Les packs sont dans Azure Blob Storage. Les references et la liste des packs sont dans Ref-CAS, un service de journal répliqué.
Pourquoi faut-il plusieurs répliques pour un dépôt ?
Parce que l'indexation des packs et la vérification de la connectivité des objets consomment beaucoup de CPU. Plusieurs nœuds répartissent le travail et améliorent la tolérance aux pannes.
Ce qu'il faut surveiller quand Rubicon arrivera sur les dépôts de tous
Le vrai test sera le passage des chiffres internes aux dépôts réels. Voici ce qu'il faut garder à l'œil.
- Suis les prochains articles de la série de GitHub sur les deux composants analysés en détail, pour comprendre les compromis.
- Vérifie si les temps de push et de fetch de tes dépôts évoluent dans les prochains mois.
- Contrôle si GitHub publie des limites ou des règles d'usage pour les agents qui font de nombreux push en parallèle.