Ing. Calogero Bono
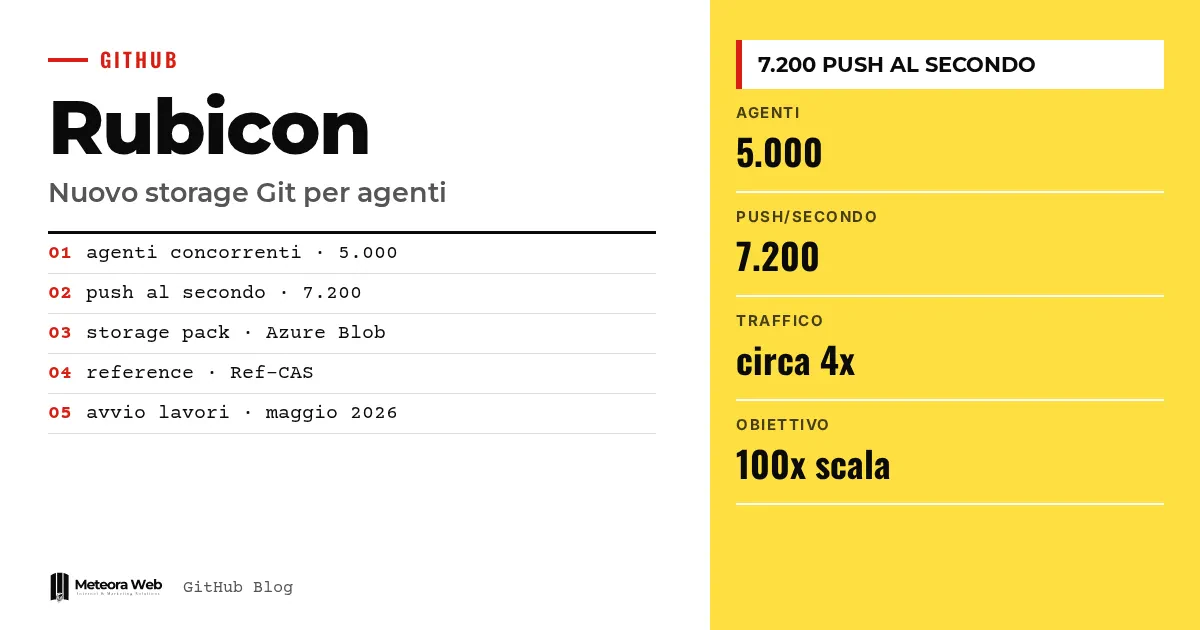
GitHubは、GitHub Universeで発表した新しいGitストレージ構造「Rubicon」について説明しました。同社によると、社内テストでは1つのリポジトリに対して5,000の同時エージェントを処理し、毎秒7,200回のpushと低遅延の読み取りを実現したとのことです。コーディングエージェントがリポジトリの負荷を変えつつある今、GitHubが現在支えている規模も、1年後には足りなくなるかもしれません。
事実に入る前に、いくつかの用語を確認しましょう。 エージェントは、自律的にコードを書きpushするAIプログラムです。Referenceは、ブランチのようなコミットへのポインタです。Packは、Gitのオブジェクトをまとめたファイルです。Compare-and-swapは、他から変更されていない場合にだけ値を更新する操作です。Blob Storageは、Azureのオブジェクトストレージサービスです。
Rubiconとは何で、なぜGitHubは作ったのか?
Rubiconは、GitHubがGitのデータを保存し提供する方法を作り直したプロジェクトの名前です。GitHubの記事によると、作業は2026年5月に始まり、初期のAzureへの移行の直後に進められました。
その理由は負荷です。GitHubによれば、現在もっとも利用の多いリポジトリでも、書き込みは短いバースト状態で多くても毎秒数十回程度です。エージェントが並行して継続的に動くようになれば、1年以内にそれが常態になると見込んでいます。そのため、少なくとも2桁の拡張を目標に掲げました。
GitHubはどのような規模の要件を設定しましたか?
GitHubは2つの軸を区別しています。水平方向のスケールは多数のリポジトリに関するもので、パーティショニングや負荷に応じたルーティングといった、すでに実績のある手法が使われています。垂直方向のスケールは、1つの非常に大きく利用の多いリポジトリに関するもので、ほとんどの要件はここから生じています。
1つのリポジトリについて、このアーキテクチャは毎秒数千回の書き込みを受け入れ、複数の書き込みノードをサポートしなければなりません。また、エージェントは各pushの完了を待ってから次の作業に進むため、コミットの遅延も抑える必要があります。さらに、CI、デプロイ、ほかのエージェントなどによって、pushごとに多くの読み取りが発生します。GitHubはこれを強い増幅効果と表現しています。
例として、あるリポジトリの1日あたりのトラフィックが、3月から5月にかけて約4倍に増えたことが挙げられています。
新しいアーキテクチャはどのように機能しますか?
出発点は、合意が必要なのは参照の更新だけだという考え方です。Gitのオブジェクトは不変で、内容によって識別されるため、複数の書き込み元が同時に保存できます。これにより、ストレージ、リクエスト処理、メンテナンスをそれぞれ独立して拡張できます。
リクエストはSpokesに届き、Spokesはこれまでどおりルーティングと負荷分散を担当します。その下には新しいデータプレーンがあり、仮想レプリカと、ローカルディスクが再構築可能なキャッシュにすぎない使い捨ての計算資源で構成されています。永続的な状態は2か所に置かれます。
- Packと高速化用データは Azure Blob Storage に置かれます。
- 参照とPackの一覧(マニフェスト)は、レプリケートされたログサービスであるRef-CASに置かれます。
書き込みでは、Packのインデックスを作成してBlob Storageにアップロードし、Ref-CASに対して1回のトランザクションを実行します。読み取りでは、参照のバージョンを確認し、不足しているPackをダウンロードして、キャッシュから応答します。Packの圧縮は、レプリカとは別のノードで実行されます。
毎日Gitを使う人にとって何か変わりますか?
GitHubによれば、変わりません。Gitは従来どおりGitのままで、push、fetch、ブランチ操作は同じ方法で同じ保護のもとで動きます。変更は見えないところで進められ、プラットフォームは稼働を続けたまま移行されます。
このテーマは、OpenAIがPierreを買収するケースのように、エージェント向けGitツールをめぐる動きともつながっています。Git bisectとblameのような基本コマンドに慣れている人であれば、使い方を変える必要はありません。
知っておくべき制限
5,000エージェントと毎秒7,200回のpushという数字は、GitHubが公表した社内テストによるもので、外部からの検証はありません。提供された本文は、詳しく解説される2つのコンポーネントの説明の前で終わっているため、技術的なトレードオフはわかりません。すべてのリポジトリへの導入時期も明らかになっていません。
デジタル作業をする人にとっての変化
小規模なチームや代理店にとって、当面はほとんど影響がありません。重要なのは別の点です。pushを多く行うエージェントを使ったワークフローを持つ場合、GitHubはその負荷に耐えられるよう準備を進めているということです。GitLab CI/CDとGitHub Actionsの比較でも触れられているように、pushごとに連鎖的な読み取りが発生するため、自社のパイプラインを見直す価値はあります。多数の顧客を抱えるプラットフォームを構築している場合は、マルチテナントにも通じる、計算とデータを分離するという考え方が参考になるでしょう。
私たちの見解
Rubiconは真剣に取り組まれたエンジニアリングの成果で、参照だけを調整するという発想はエレガントです。ただし、名前が示すように、GitHubはエージェントによる負荷を後戻りできない転換点と捉え、それを前提としています。予想どおりに成長するのか、それとも合成テストが実際の利用を過大に見積もるのかは、まだわかりません。ベンダー自身のデータだけでなく、独立した検証データが必要です。
よくある質問
GitHubのProject Rubiconとは何ですか?
GitHub Universeで発表された、GitHubの新しいGitストレージ構造です。ストレージと計算を分離し、参照の更新だけを調整します。
どれだけの毎秒pushに耐えられますか?
社内テストでは、5,000の同時エージェントで1つのリポジトリに毎秒7,200回のpushを処理できたとGitHubは説明しています。これは同社の発表であり、第三者による検証はされていません。
Gitの使い方を変える必要がありますか?
いいえ。GitHubによると、push、fetch、ブランチ操作は従来どおり同じ保護のもとで動作します。
データはどこに保存されますか?
Packファイルは Azure Blob Storage に保存されます。参照とPackの一覧(マニフェスト)は、レプリケートされたログサービスであるRef-CASに保存されます。
なぜ1つのリポジトリに複数のレプリカが必要なのですか?
Packのインデックス作成やオブジェクトの接続性チェックには多くのCPUが必要だからです。ノードを増やすと処理を分散でき、障害への耐性も高まります。
Rubiconが誰のリポジトリにも届くとき注目すべき点
本当の試金石は、社内の数字から実際のリポジトリへの移行です。以下の点に注目してください。
- GitHubが公開する2つの詳細なコンポーネントに関するシリーズ記事を追い、トレードオフを理解しましょう。
- 今後数か月で、自分のリポジトリのpushやfetchの時間が変わるかを確認しましょう。
- GitHubが、多数の並列pushを行うエージェント向けに制限や利用ルールを公開するかを確かめましょう。