Ing. Calogero Bono
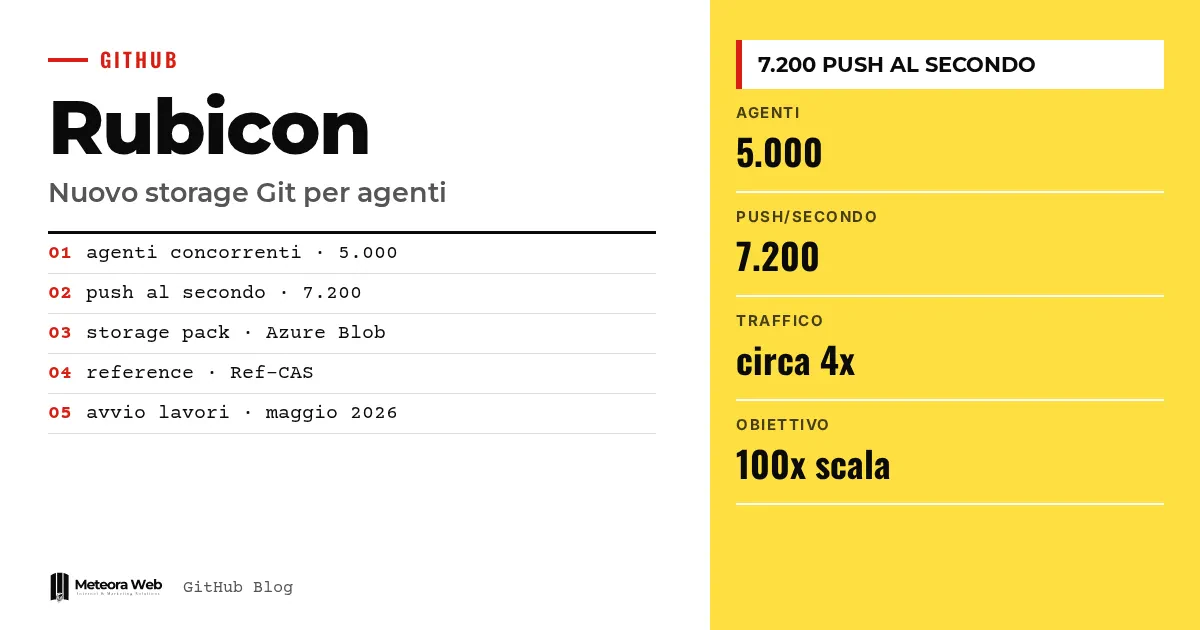
GitHub ha descrito Rubicon, la nueva arquitectura de almacenamiento Git anunciada en GitHub Universe. Según la empresa, en sus pruebas internas soportó 5.000 agentes concurrentes en un repositorio, con 7.200 push por segundo y lecturas de baja latencia. Importa porque los agentes de programación están cambiando la carga de los repositorios, y lo que hoy aguanta GitHub podría no bastar dentro de un año.
Algunos términos, antes de entrar en los hechos. Agente es un programa de IA que escribe código y hace push por su cuenta. Reference es el puntero a un commit, como una rama. Pack es el archivo que agrupa los objetos de Git. Compare-and-swap es una operación que actualiza un valor solo si nadie lo ha cambiado mientras tanto. Blob Storage es el servicio de almacenamiento de objetos de Azure.
¿Qué es Rubicon y por qué lo ha construido GitHub?
Rubicon es el nombre del proyecto con el que GitHub ha rediseñado cómo conserva y sirve los datos de Git. Según el artículo de GitHub, el trabajo empezó en mayo de 2026, justo después de la migración inicial a Azure.
El motivo es la carga. GitHub afirma que hoy los repositorios más transitados reciben como máximo decenas de escrituras por segundo, en ráfagas breves. Con agentes que trabajan en paralelo y de forma continua, espera que eso se convierta en un ritmo constante dentro de un año. Por eso se ha marcado un objetivo de al menos dos órdenes de magnitud más.
¿Qué requisitos de escala ha fijado GitHub?
GitHub distingue dos ejes. La escala horizontal se refiere a muchos repositorios, y aquí siguen valiendo soluciones ya probadas como el particionado y el enrutamiento según la carga. La escala vertical se refiere a un solo repositorio muy grande y muy ocupado, y de ahí salen casi todos los requisitos.
Para un único repositorio, la arquitectura debe aceptar miles de escrituras por segundo y admitir varios nodos de escritura. También debe reducir la latencia de los commits, porque un agente espera cada push antes del paso siguiente. Además, cada push genera más lecturas, entre CI, despliegues y otros agentes, y GitHub habla de un fuerte efecto de amplificación.
Un ejemplo citado es un repositorio cuyo tráfico diario creció unas 4 veces entre marzo y mayo.
¿Cómo funciona la nueva arquitectura?
La idea de partida es que solo hace falta acuerdo para actualizar las referencias. Los objetos de Git son inmutables y se identifican por su contenido, así que varios escritores pueden guardarlos a la vez. Así, el almacenamiento, el servicio de peticiones y el mantenimiento escalan de forma independiente.
Las peticiones llegan a Spokes, que sigue encargándose del enrutamiento y del balanceo. Debajo hay un nuevo plano de datos, con réplicas virtuales y cómputo efímero cuyo disco local es solo una caché reconstruible. El estado duradero está en dos lugares.
- Packs y datos de aceleración en Azure Blob Storage.
- Referencias y lista de packs (el manifiesto) en Ref-CAS, un servicio de registro replicado.
Una escritura indexa el pack, lo sube a Blob Storage y hace una sola transacción en Ref-CAS. Una lectura comprueba la versión de las referencias, descarga los packs que faltan y responde desde la caché. La compactación de packs se ejecuta en nodos separados, nunca en las réplicas.
¿Cambia algo para quien usa Git a diario?
Según GitHub, no. Git sigue siendo Git, con push, fetch y ramas igual que siempre y con las mismas protecciones. El cambio está bajo el capó y se lleva a cabo mientras la plataforma sigue funcionando.
El tema se relaciona con lo que está pasando en las herramientas Git para agentes, como en el caso de OpenAI que adquiere Pierre. Quien conoce bien los comandos básicos, por ejemplo con Git bisect y blame, no tiene que cambiar sus hábitos.
Límites que conviene conocer
Las cifras de 5.000 agentes y 7.200 push por segundo proceden de pruebas internas declaradas por GitHub, sin verificación externa. El texto disponible se interrumpe antes de los detalles de los dos componentes analizados en profundidad, así que no conocemos los compromisos técnicos. No constan fechas de adopción completas para todos los repositorios.
Qué cambia para quien trabaja con lo digital
Para una agencia o un equipo pequeño, a corto plazo casi nada. El punto es otro. Si tus flujos de trabajo usan agentes que hacen muchos push, GitHub se está preparando para que aguanten. Sigue siendo útil revisar tu propio pipeline, porque cada push genera lecturas en cadena, como se describe también en la comparativa entre GitLab CI/CD y GitHub Actions. Quien construye plataformas con muchos clientes puede fijarse en el principio de separar cómputo y datos, un tema cercano al multi-tenant.
Nuestra opinión
Rubicon es un proyecto de ingeniería serio, y la idea de coordinar solo las referencias es elegante. Pero el nombre también dice otra cosa. GitHub considera la carga de los agentes un punto de no retorno, y lo da por seguro. Queda por ver si el crecimiento será realmente el previsto o si las pruebas sintéticas sobrestimarán el uso real. Harían falta datos independientes, no solo los del proveedor.
Preguntas frecuentes
¿Qué es Project Rubicon de GitHub?
Es la nueva arquitectura de almacenamiento Git de GitHub, anunciada en GitHub Universe. Separa almacenamiento y cómputo y coordina solo las actualizaciones de las referencias.
¿Cuántos push por segundo soporta?
En sus pruebas internas, GitHub declara 7.200 push por segundo en un repositorio, con 5.000 agentes concurrentes. Son datos de la empresa, no verificados por terceros.
¿Tengo que cambiar la forma en que uso Git?
No. Según GitHub, push, fetch y las ramas funcionan igual que antes, con las mismas protecciones.
¿Dónde se guardan los datos?
Los packs están en Azure Blob Storage. Las referencias y la lista de packs están en Ref-CAS, un servicio de registro replicado.
¿Por qué hacen falta más réplicas por repositorio?
Porque indexar los packs y comprobar la conectividad de los objetos consume mucha CPU. Más nodos reparten el trabajo y mejoran la tolerancia a fallos.
Qué vigilar cuando Rubicon llegue a los repositorios de todos
La prueba real será el paso de las cifras internas a repositorios reales. Esto es lo que conviene seguir.
- Sigue los próximos artículos de la serie de GitHub sobre los dos componentes analizados en profundidad, para entender los compromisos.
- Comprueba si los tiempos de push y fetch de tus repositorios cambian en los próximos meses.
- Revisa si GitHub publica límites o normas de uso para agentes con muchos push en paralelo.