Ing. Calogero Bono
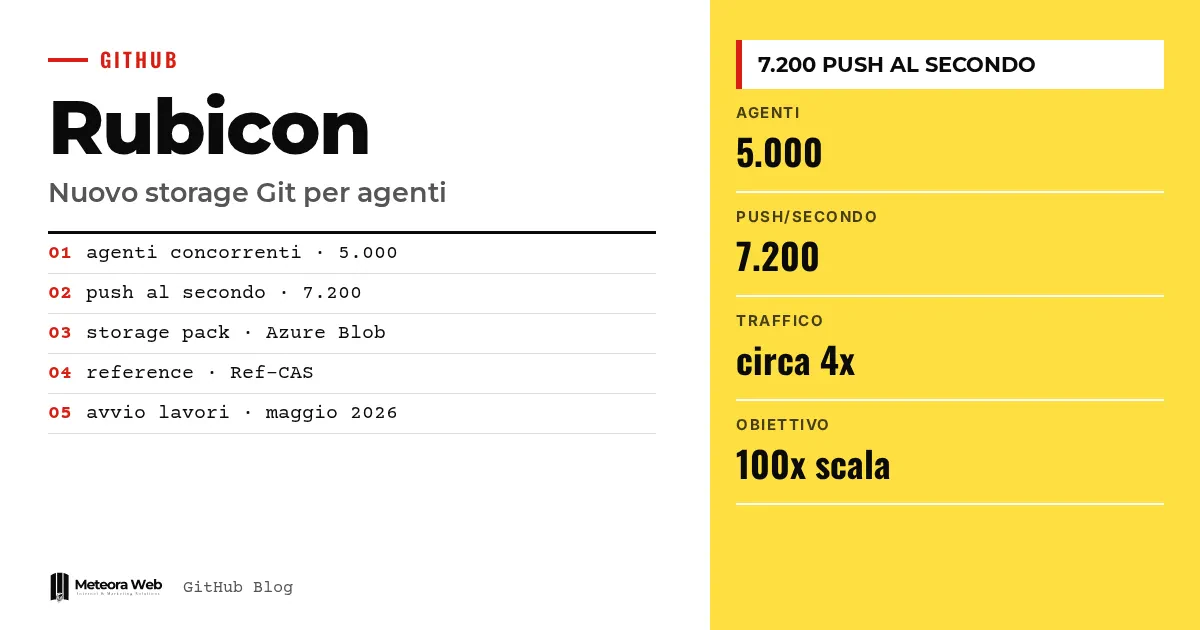
GitHub ha descritto Rubicon, la nuova architettura di storage Git annunciata a GitHub Universe. Secondo l'azienda, nei test interni ha retto 5.000 agenti concorrenti su un repository, con 7.200 push al secondo e letture a bassa latenza. Conta perché gli agenti di programmazione stanno cambiando il carico dei repository, e quello che regge GitHub oggi potrebbe non bastare tra un anno.
Qualche termine, prima di entrare nei fatti. Agente è un programma di IA che scrive codice e fa push da solo. Reference è il puntatore a un commit, come un ramo. Pack è il file che raccoglie gli oggetti Git. Compare-and-swap è un'operazione che aggiorna un valore solo se nessuno l'ha cambiato nel frattempo. Blob Storage è il servizio di archiviazione a oggetti di Azure.
Che cos'è Rubicon e perché GitHub lo ha costruito?
Rubicon è il nome del progetto con cui GitHub ha ridisegnato come conserva e serve i dati Git. Secondo l'articolo di GitHub, il lavoro è iniziato a maggio 2026, subito dopo la migrazione iniziale verso Azure.
Il motivo è il carico. GitHub dichiara che oggi i repository più trafficati ricevono al massimo decine di scritture al secondo, in brevi raffiche. Con agenti che lavorano in parallelo e di continuo, si aspetta che diventino un ritmo costante entro un anno. Per questo ha fissato un obiettivo di almeno due ordini di grandezza in più.
Quali requisiti di scala ha fissato GitHub?
GitHub distingue due assi. La scala orizzontale riguarda i molti repository, e qui restano le soluzioni già collaudate come partizionamento e routing in base al carico. La scala verticale riguarda un solo repository molto grande e occupato, ed è da qui che arrivano quasi tutti i requisiti.
Per un singolo repository l'architettura deve accettare migliaia di scritture al secondo e supportare più nodi di scrittura. Deve anche ridurre la latenza dei commit, perché un agente aspetta ogni push prima del passo successivo. Ogni push genera inoltre più letture, tra CI, deploy e altri agenti, e GitHub parla di un forte effetto di amplificazione.
Un esempio citato è un repository il cui traffico giornaliero è cresciuto circa 4 volte tra marzo e maggio.
Come funziona la nuova architettura?
L'idea di partenza è che serve accordo solo sull'aggiornamento delle reference. Gli oggetti Git sono immutabili e identificati dal contenuto, quindi più scrittori possono salvarli insieme. Così archiviazione, servizio delle richieste e manutenzione si scalano in modo indipendente.
Le richieste arrivano a Spokes, che continua a occuparsi di routing e bilanciamento. Sotto c'è un piano dati nuovo, con repliche virtuali, calcolo usa e getta il cui disco locale è solo una cache ricostruibile. Lo stato durevole sta in due posti.
- Pack e dati di accelerazione in Azure Blob Storage.
- Reference ed elenco dei pack (il manifest) in Ref-CAS, un servizio di log replicato.
Una scrittura indicizza il pack, lo carica su Blob Storage e fa una sola transazione su Ref-CAS. Una lettura controlla la versione delle reference, scarica i pack che mancano e risponde dalla cache. La compattazione dei pack gira su nodi separati, mai sulle repliche.
Cambia qualcosa per chi usa Git ogni giorno?
Secondo GitHub no. Git resta Git, con push, fetch e branch nello stesso modo e con le stesse protezioni. Il cambiamento è sotto il cofano e viene portato avanti mentre la piattaforma resta in funzione.
Il tema si lega a quanto sta accadendo negli strumenti Git per gli agenti, come nel caso di OpenAI che acquisisce Pierre. Chi conosce bene i comandi di base, ad esempio con Git bisect e blame, non deve cambiare abitudini.
Limiti da conoscere
I numeri sui 5.000 agenti e i 7.200 push al secondo vengono da test interni dichiarati da GitHub, senza verifica esterna. Il testo fornito si interrompe prima dei dettagli sui due componenti approfonditi, quindi non conosciamo i compromessi tecnici. Non risultano date di adozione complete per tutti i repository.
Cosa cambia per chi lavora con il digitale
Per un'agenzia o un team piccolo, nell'immediato quasi nulla. Il punto è un altro. Se i tuoi flussi di lavoro usano agenti che fanno molti push, GitHub si sta attrezzando perché reggano. Resta utile ragionare sulla propria pipeline, perché ogni push genera letture a catena, come descritto anche nel confronto tra GitLab CI/CD e GitHub Actions. Chi costruisce piattaforme con molti clienti può osservare il principio di separare calcolo e dati, tema vicino al multi-tenant.
Il nostro parere
Rubicon è un progetto ingegneristico serio, e l'idea di coordinare solo le reference è elegante. Ma il nome dice anche altro. GitHub considera il carico degli agenti un punto di non ritorno, e lo dà per certo. Resta da vedere se la crescita sarà davvero quella prevista o se i test sintetici sopravvaluteranno l'uso reale. Servirebbero dati indipendenti, non solo quelli del fornitore.
Domande frequenti
Che cos'è Project Rubicon di GitHub?
È la nuova architettura di storage Git di GitHub, annunciata a GitHub Universe. Separa archiviazione e calcolo e coordina solo gli aggiornamenti delle reference.
Quanti push al secondo regge?
Nei test interni GitHub dichiara 7.200 push al secondo su un repository, con 5.000 agenti concorrenti. Sono dati dell'azienda, non verificati da terzi.
Devo cambiare il modo in cui uso Git?
No. Secondo GitHub push, fetch e branch funzionano come prima, con le stesse protezioni.
Dove vengono salvati i dati?
I pack stanno in Azure Blob Storage. Reference ed elenco dei pack stanno in Ref-CAS, un servizio di log replicato.
Perché servono più repliche per un repository?
Perché indicizzare i pack e controllare la connettività degli oggetti consuma molta CPU. Più nodi distribuiscono il lavoro e migliorano la tolleranza ai guasti.
Cosa guardare quando Rubicon arriva ai repository di tutti
Il test vero sarà il passaggio da numeri interni a repository reali. Ecco cosa tenere d'occhio.
- Segui i prossimi articoli della serie di GitHub sui due componenti approfonditi, per capire i compromessi.
- Controlla se i tempi di push e fetch dei tuoi repository cambiano nei prossimi mesi.
- Verifica se GitHub pubblica limiti o regole d'uso per agenti con molti push paralleli.