Ing. Calogero Bono
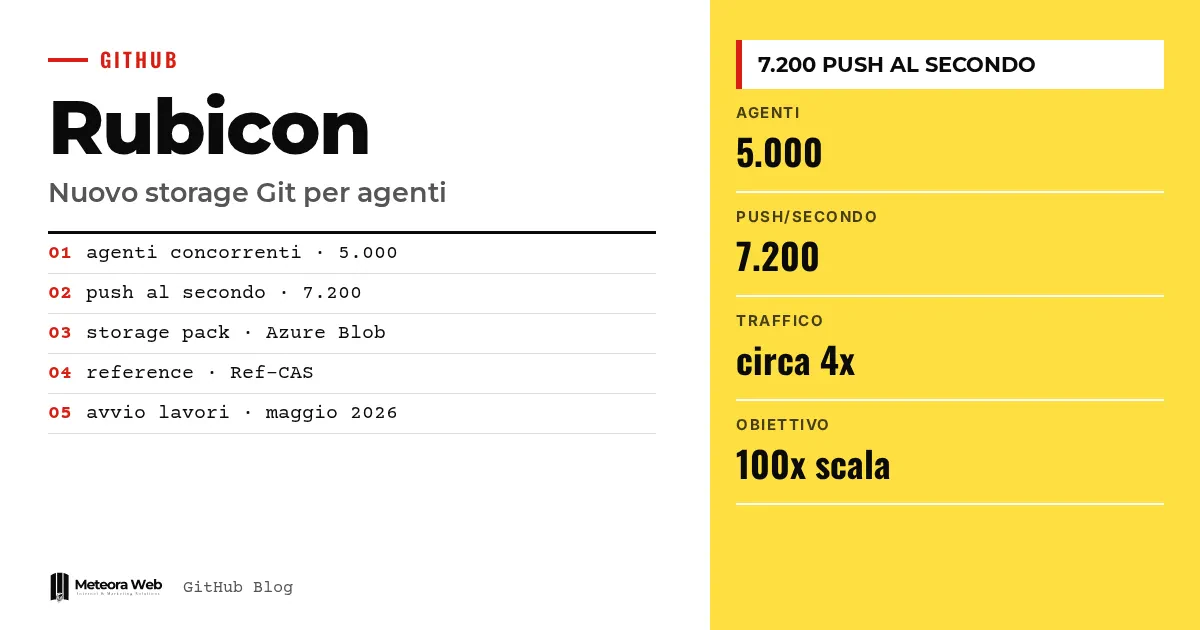
GitHub opisał Rubicon, nową architekturę przechowywania Git zapowiedzianą podczas GitHub Universe. Według firmy w wewnętrznych testach wytrzymała 5.000 równoległych agentów na jednym repozytorium, przy 7.200 push na sekundę i odczytach o niskim opóźnieniu. To ważne, bo agenci programistyczni zmieniają obciążenie repozytoriów, a to, co dziś wystarcza GitHubowi, za rok może już nie wystarczyć.
Kilka pojęć, zanim przejdziemy do faktów. Agent to program AI, który sam pisze kod i wykonuje push. Reference to wskaźnik na commit, podobny do gałęzi. Pack to plik grupujący obiekty Git. Compare-and-swap to operacja, która aktualizuje wartość tylko wtedy, gdy nikt jej w międzyczasie nie zmienił. Blob Storage to usługa przechowywania obiektów w Azure.
Czym jest Rubicon i dlaczego GitHub go zbudował?
Rubicon to nazwa projektu, w ramach którego GitHub przeprojektował sposób przechowywania i obsługi danych Git. Według artykułu GitHuba prace ruszyły w maju 2026, zaraz po pierwszej migracji do Azure.
Powodem jest obciążenie. GitHub twierdzi, że dziś najbardziej obciążone repozytoria przyjmują co najwyżej kilkadziesiąt zapisów na sekundę, w krótkich seriach. Gdy agenci będą pracować równolegle i nieustannie, takie tempo ma stać się stałe w ciągu roku. Dlatego firma wyznaczyła cel co najmniej dwóch rzędów wielkości więcej.
Jakie wymagania skali postawił GitHub?
GitHub rozróżnia dwie osie. Skalowanie poziome dotyczy wielu repozytoriów i tu sprawdzone rozwiązania, takie jak partycjonowanie i routing zależny od obciążenia, nadal działają. Skalowanie pionowe dotyczy jednego, bardzo dużego i zajętego repozytorium, i stąd pochodzi niemal każde wymaganie.
Pojedyncze repozytorium ma obsłużyć tysiące zapisów na sekundę i wspierać wiele węzłów zapisu. Musi też zmniejszyć opóźnienie commitów, bo agent czeka na każdy push przed kolejnym krokiem. Każdy push generuje dodatkowe odczyty, z CI, wdrożeń i innych agentów, a GitHub mówi o silnym efekcie wzmocnienia.
Jako przykład podano repozytorium, którego dzienny ruch wzrósł około czterokrotnie między marcem a majem.
Jak działa nowa architektura?
Punkt wyjścia jest taki, że zgoda jest potrzebna tylko przy aktualizacji referencji. Obiekty Git są niezmienne i identyfikowane przez treść, więc wielu zapisujących może zapisywać je jednocześnie. Dzięki temu przechowywanie, obsługa żądań i utrzymanie skalują się niezależnie.
Żądania trafiają do Spokes, który nadal zajmuje się routingiem i równoważeniem obciążenia. Pod spodem działa nowa warstwa danych z wirtualnymi replikami i jednorazowymi obliczeniami, których lokalny dysk jest tylko odtwarzalnym cache. Trwały stan znajduje się w dwóch miejscach.
- Packi i dane przyspieszające w Azure Blob Storage.
- Referencje i lista packów (manifest) w Ref-CAS, replikowanej usłudze logów.
Zapis indeksuje pack, wysyła go do Blob Storage i wykonuje jedną transakcję w Ref-CAS. Odczyt sprawdza wersję referencji, pobiera brakujące packi i odpowiada z cache. Kompaktowanie packów działa na osobnych węzłach, nigdy na replikach.
Czy zmieni się coś dla osób używających Gita na co dzień?
Według GitHuba nie. Git pozostaje Gitem, z push, fetch i branch działającymi tak samo i z tymi samymi zabezpieczeniami. Zmiana dzieje się pod maską i jest wdrażana, gdy platforma pozostaje w działaniu.
Temat łączy się z tym, co dzieje się w narzędziach Git dla agentów, jak w przypadku przejęcia Pierre przez OpenAI. Osoby znające podstawowe polecenia, na przykład z Git bisect i blame, nie muszą zmieniać przyzwyczajeń.
Ograniczenia, które warto znać
Liczby o 5.000 agentach i 7.200 push na sekundę pochodzą z wewnętrznych testów zadeklarowanych przez GitHub, bez zewnętrznej weryfikacji. Dostarczony tekst urywa się przed szczegółami dwóch omawianych komponentów, więc nie znamy kompromisów technicznych. Nie ma pełnych dat wdrożenia dla wszystkich repozytoriów.
Co się zmienia dla osób pracujących z technologią
Dla agencji albo małego zespołu na razie prawie nic. Ważne jest coś innego. Jeśli Twoje procesy korzystają z agentów wykonujących wiele push, GitHub przygotowuje się, aby to wytrzymać. Warto i tak przemyśleć swój pipeline, bo każdy push generuje kolejne odczyty, o czym mowa także w porównaniu GitLab CI/CD i GitHub Actions. Osoby budujące platformy dla wielu klientów mogą zauważyć zasadę rozdzielania obliczeń i danych, bliską tematowi multi-tenant.
Nasza opinia
Rubicon to poważny projekt inżynierski, a pomysł koordynowania tylko referencji jest elegancki. Sama nazwa sugeruje jednak coś więcej. GitHub traktuje obciążenie agentami jako punkt bez powrotu i zakłada, że nadejdzie na pewno. Zobaczymy, czy wzrost będzie naprawdę taki, jak zapowiedziano, czy syntetyczne testy przeszacują realne użycie. Potrzebne są niezależne dane, a nie tylko te od dostawcy.
Najczęstsze pytania
Czym jest Project Rubicon w GitHubie?
To nowa architektura przechowywania Git w GitHubie, zapowiedziana podczas GitHub Universe. Rozdziela przechowywanie i obliczenia oraz koordynuje tylko aktualizacje referencji.
Ile push na sekundę wytrzymuje?
W wewnętrznych testach GitHub deklaruje 7.200 push na sekundę na jednym repozytorium, przy 5.000 równoległych agentach. To dane firmy, niezweryfikowane przez strony trzecie.
Czy muszę zmienić sposób pracy z Gitem?
Nie. Według GitHuba push, fetch i branch działają tak samo, z tymi samymi zabezpieczeniami.
Gdzie są przechowywane dane?
Pliki pack znajdują się w Azure Blob Storage. Referencje i lista packów są w Ref-CAS, replikowanej usłudze logów.
Po co repozytorium potrzebuje więcej replik?
Bo indeksowanie packów i sprawdzanie połączenia obiektów zużywa dużo CPU. Więcej węzłów rozkłada pracę i zwiększa odporność na awarie.
Na co patrzeć, gdy Rubicon trafi do wszystkich repozytoriów
Prawdziwym testem będzie przejście od wewnętrznych liczb do rzeczywistych repozytoriów. Oto, na co warto zwracać uwagę.
- Śledź kolejne artykuły z serii GitHuba o dwóch omawianych komponentach, aby zrozumieć kompromisy.
- Sprawdzaj, czy czasy push i fetch w Twoich repozytoriach zmieniają się w najbliższych miesiącach.
- Weryfikuj, czy GitHub publikuje limity lub zasady użycia dla agentów wykonujących wiele równoległych push.