Ing. Calogero Bono
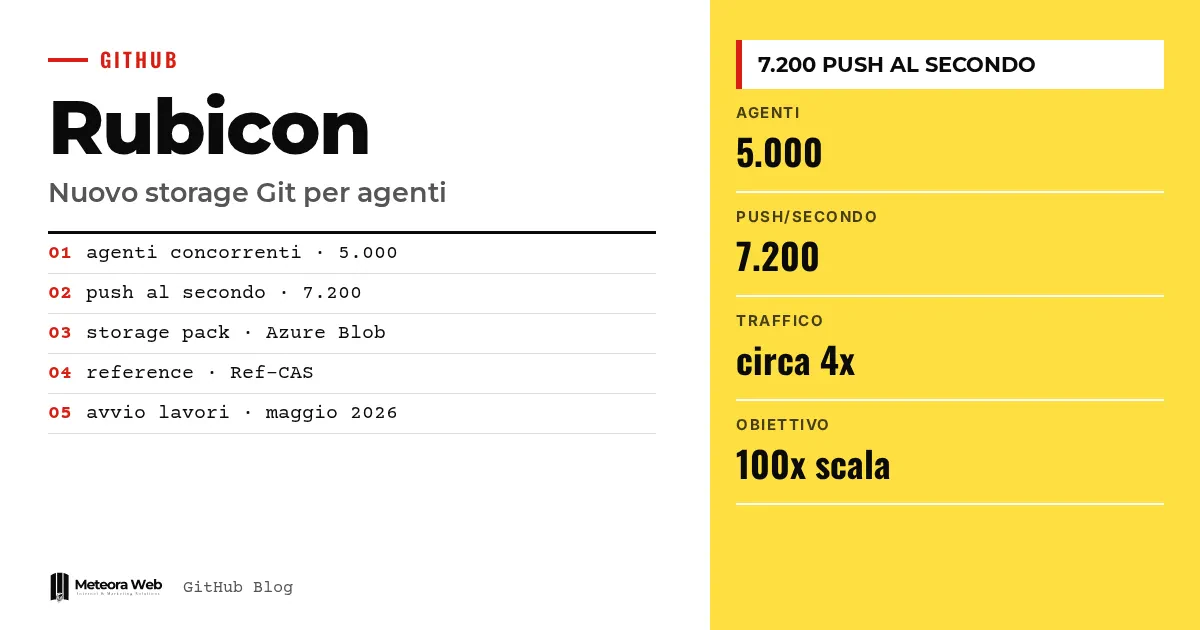
GitHub 在 GitHub Universe 大会上介绍了 Rubicon, 这是一套全新的 Git 存储架构。据该公司称, 在内部测试中, 它在单个仓库上支撑了 5000 个并发代理, 每秒处理 7200 次推送, 并保持低延迟读取。这很重要, 因为编程代理正在改变仓库的负载方式, 而今天 GitHub 能扛住的规模, 一年后未必够用。
在进入具体内容之前, 先了解几个术语。 代理是一种自动编写代码并自行推送的 AI 程序。Reference是指向提交的指针, 类似分支。Pack是汇集 Git 对象的文件。Compare-and-swap是一种仅在值未被他人改动时才更新它的操作。Blob Storage是 Azure 的对象存储服务。
Rubicon 是什么, GitHub 为何要构建它?
Rubicon 是 GitHub 重新设计 Git 数据存储与服务方式的项目名称。据 GitHub 的文章介绍, 该工作始于 2026 年 5 月, 紧随最初迁移到 Azure 之后。
原因在于负载。GitHub 称, 目前流量最大的仓库最多每秒接收几十次写入, 且呈短促爆发。随着代理持续并行工作, 它预计这会在一年内变成稳定的节奏。因此它设定了至少再提升两个数量级的目标。
GitHub 设定了哪些规模要求?
GitHub 区分两个维度。水平扩展针对大量仓库, 这里已有分区和按负载路由等成熟方案。垂直扩展针对单个超大且高负载的仓库, 几乎所有要求都来自这里。
对于单个仓库, 架构必须能承受每秒数千次写入, 并支持多个写入节点。它还必须降低提交延迟, 因为代理在每次推送完成后才会进行下一步。此外, 每次推送还会带来更多读取, 包括 CI、部署以及其他代理, GitHub 称这种放大效应非常明显。
文中举的一个例子是, 某仓库的日流量在 3 月到 5 月间增长了约 4 倍。
新架构如何运作?
出发点是 – 只有引用的更新需要达成共识。Git 对象不可变且由内容标识, 因此多个写入者可以一起保存它们。这样存储、请求处理和维护就能各自独立扩展。
请求先到达 Spokes, 它仍负责路由和负载均衡。其下是一个新的数据平面, 包括虚拟副本, 以及本地磁盘仅作可重建缓存的临时计算资源。持久状态保存在两个地方。
- Pack 和加速数据存放在 Azure Blob Storage。
- 引用和 Pack 列表(清单)存放在 Ref-CAS 中, 这是一个复制日志服务。
一次写入会为 Pack 建立索引, 将其上传到 Blob Storage, 然后在 Ref-CAS 中完成一次事务。一次读取会检查引用版本, 下载缺失的 Pack, 并从缓存中响应。Pack 压缩在独立节点上运行, 绝不在副本上进行。
对每天使用 Git 的人有影响吗?
据 GitHub 称没有。Git 仍然是 Git, 推送、拉取和分支的使用方式不变, 保护机制也相同。变化在底层, 且是在平台持续运行的同时推进的。
这一话题与 Git 代理工具的发展密切相关, 例如OpenAI 收购 Pierre的案例。熟悉基础命令的人, 比如使用Git bisect 和 blame的人, 无需改变习惯。
需要了解的局限
5000 个代理和每秒 7200 次推送的数字来自 GitHub 公布的内部测试, 尚未经过外部验证。提供的文本在两个深入介绍的组件之前就中断了, 因此我们不清楚其中的技术权衡。也没有公布所有仓库的完整采用时间表。
对数字工作者意味着什么
对于一个机构或小团队来说, 短期内几乎没有影响。真正的重点在别处。如果你的工作流使用会频繁推送的代理, GitHub 正在为此做好准备。仍然值得审视你自己的流水线, 因为每次推送都会引发一连串读取, 这在GitLab CI/CD 与 GitHub Actions 的对比中也有提到。构建多客户平台的团队可以借鉴计算与数据分离的思路, 这与多租户的主题相近。
我们的看法
Rubicon 是一个严肃的工程项目, 只协调引用的想法很优雅。但它的名字也透露了更多信息。GitHub 把代理带来的负载视为不可逆的转折点, 并将其视为既定事实。能否真正达到预期的增长, 还有待观察, 合成测试也可能高估实际使用情况。需要的是独立数据, 而不只是供应商自己的数字。
常见问题
GitHub 的 Project Rubicon 是什么?
它是 GitHub 全新的 Git 存储架构, 在 GitHub Universe 大会上发布。它将存储与计算分离, 只协调引用的更新。
它每秒能处理多少次推送?
GitHub 在内部测试中宣称, 单个仓库每秒可处理 7200 次推送, 同时支撑 5000 个并发代理。这是公司自己的数据, 未经第三方验证。
我需要改变使用 Git 的方式吗?
不需要。据 GitHub 称, 推送、拉取和分支的操作方式不变, 保护机制也相同。
数据存放在哪里?
Pack 文件存放在 Azure Blob Storage。引用和 Pack 列表存放在 Ref-CAS 中, 这是一个复制日志服务。
为什么一个仓库需要更多副本?
因为为 Pack 建立索引和检查对象连通性会消耗大量 CPU。更多节点可以分担工作, 并提高容错能力。
Rubicon 进入所有人的仓库之后, 该关注什么
真正的考验是从内部数字过渡到真实仓库。以下是值得留意的几点。
- 关注 GitHub 后续关于两个深入组件的系列文章, 以了解其中的权衡。
- 观察未来几个月你的仓库推送和拉取耗时是否发生变化。
- 留意 GitHub 是否针对多并发推送的代理公布限制或使用规则。