Ing. Calogero Bono
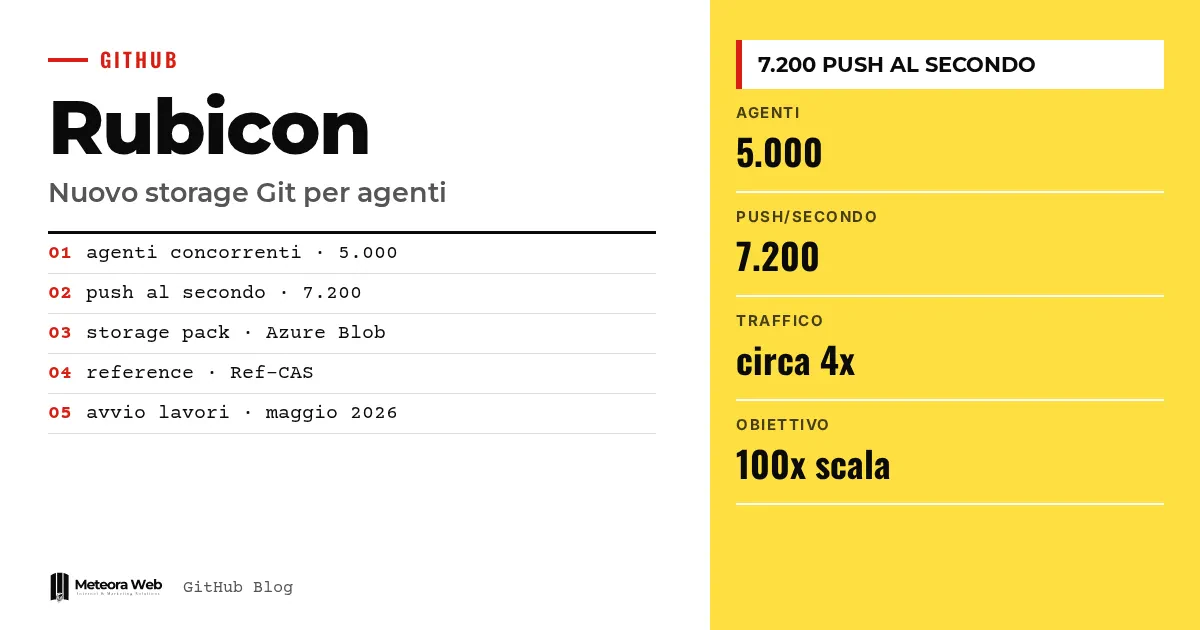
O GitHub descreveu o Rubicon, a nova arquitetura de storage Git anunciada no GitHub Universe. Segundo a empresa, nos testes internos ela suportou 5.000 agentes simultâneos em um repositório, com 7.200 pushes por segundo e leituras de baixa latência. Isso importa porque os agentes de programação estão mudando a carga dos repositórios, e o que o GitHub aguenta hoje pode não bastar daqui a um ano.
Alguns termos, antes de entrar nos fatos. Agente é um programa de IA que escreve código e faz push sozinho. Reference é o ponteiro para um commit, como uma branch. Pack é o arquivo que reúne os objetos Git. Compare-and-swap é uma operação que atualiza um valor somente se ninguém o alterou nesse meio tempo. Blob Storage é o serviço de armazenamento de objetos do Azure.
O que é o Rubicon e por que o GitHub o construiu?
O Rubicon é o nome do projeto com que o GitHub redesenhou a forma como armazena e serve os dados Git. Segundo o artigo do GitHub, o trabalho começou em maio de 2026, logo após a migração inicial para o Azure.
O motivo é a carga. O GitHub afirma que hoje os repositórios mais movimentados recebem no máximo dezenas de escritas por segundo, em rajadas curtas. Com agentes trabalhando em paralelo e continuamente, ele espera que isso vire um ritmo constante dentro de um ano. Por isso fixou a meta de pelo menos duas ordens de grandeza a mais.
Quais requisitos de escala o GitHub definiu?
O GitHub distingue dois eixos. A escala horizontal diz respeito a muitos repositórios, e aqui continuam valendo soluções já testadas, como particionamento e roteamento baseado em carga. A escala vertical diz respeito a um único repositório muito grande e ocupado, e é daí que vêm quase todos os requisitos.
Para um único repositório, a arquitetura precisa aceitar milhares de escritas por segundo e suportar múltiplos nós de escrita. Também precisa reduzir a latência dos commits, porque um agente espera cada push antes do passo seguinte. Cada push gera ainda mais leituras, entre CI, deploys e outros agentes, e o GitHub fala em um forte efeito de amplificação.
Um exemplo citado é um repositório cujo tráfego diário cresceu cerca de 4 vezes entre março e maio.
Como funciona a nova arquitetura?
A ideia de partida é que só é preciso acordo na atualização das references. Os objetos Git são imutáveis e identificados pelo conteúdo, então vários escritores podem salvá-los juntos. Assim, armazenamento, atendimento das requisições e manutenção escalam de forma independente.
As requisições chegam ao Spokes, que continua cuidando de roteamento e balanceamento. Por baixo há um novo plano de dados, com réplicas virtuais, computação descartável cujo disco local é apenas um cache reconstruível. O estado durável fica em dois lugares.
- Packs e dados de aceleração no Azure Blob Storage.
- References e lista de packs (o manifesto) no Ref-CAS, um serviço de log replicado.
Uma escrita indexa o pack, o envia ao Blob Storage e faz uma única transação no Ref-CAS. Uma leitura verifica a versão das references, baixa os packs que faltam e responde a partir do cache. A compactação dos packs roda em nós separados, nunca nas réplicas.
Muda algo para quem usa Git todo dia?
Segundo o GitHub, não. O Git continua sendo Git, com push, fetch e branch funcionando da mesma forma e com as mesmas proteções. A mudança está por baixo dos panos e é feita enquanto a plataforma segue em operação.
O tema se liga ao que acontece com as ferramentas Git para agentes, como no caso da OpenAI que adquire a Pierre. Quem conhece bem os comandos básicos, por exemplo com Git bisect e blame, não precisa mudar seus hábitos.
Limites a conhecer
Os números sobre 5.000 agentes e 7.200 pushes por segundo vêm de testes internos declarados pelo GitHub, sem verificação externa. O texto disponível para esta tradução é interrompido antes dos detalhes sobre os dois componentes aprofundados, então não conhecemos os compromissos técnicos. Também não há datas completas de adoção para todos os repositórios.
O que muda para quem trabalha com o digital
Para uma agência ou uma equipe pequena, no curto prazo quase nada muda. O ponto é outro. Se os seus fluxos de trabalho usam agentes que fazem muitos pushes, o GitHub está se preparando para que a plataforma aguente. Vale a pena pensar na sua própria pipeline, porque cada push gera leituras em cadeia, como descrito também na comparação entre GitLab CI/CD e GitHub Actions. Quem constrói plataformas com muitos clientes pode observar o princípio de separar computação e dados, tema próximo ao multi-tenant.
Nossa opinião
O Rubicon é um projeto de engenharia sério, e a ideia de coordenar apenas as references é elegante. Mas o nome também indica outra coisa. O GitHub considera a carga dos agentes um ponto sem volta, e a trata como certa. Ainda falta ver se o crescimento será mesmo o previsto ou se os testes sintéticos vão superestimar o uso real. Seriam necessários dados independentes, não apenas os do fornecedor.
Perguntas frequentes
O que é o Project Rubicon do GitHub?
É a nova arquitetura de storage Git do GitHub, anunciada no GitHub Universe. Ela separa armazenamento e computação e coordena apenas as atualizações das references.
Quantos pushes por segundo ela aguenta?
Nos testes internos, o GitHub declara 7.200 pushes por segundo em um repositório, com 5.000 agentes simultâneos. São dados da empresa, não verificados por terceiros.
Preciso mudar a forma como uso o Git?
Não. Segundo o GitHub, push, fetch e branch continuam funcionando como antes, com as mesmas proteções.
Onde os dados são armazenados?
Os packs ficam no Azure Blob Storage. As references e a lista de packs ficam no Ref-CAS, um serviço de log replicado.
Por que um repositório precisa de mais réplicas?
Porque indexar os packs e verificar a conectividade dos objetos consome muita CPU. Mais nós distribuem o trabalho e melhoram a tolerância a falhas.
O que observar quando o Rubicon chegar aos repositórios de todos
O teste de verdade será a passagem dos números internos para repositórios reais. Veja o que acompanhar.
- Acompanhe os próximos artigos da série do GitHub sobre os dois componentes aprofundados, para entender os compromissos.
- Verifique se os tempos de push e fetch dos seus repositórios mudam nos próximos meses.
- Confira se o GitHub publica limites ou regras de uso para agentes com muitos pushes paralelos.